2018/01/12
RubyでつくるRuby発売中


2017/12/31
2018年賀状
年賀状書いた。
%!
<< /PageSize [285 420] >> setpagedevice

% excerpt from Bill Casselman's
% "Mathematical Illustrations - a manual of geometry and PostScript"
/ctransform { load
    1 dict begin
    /f exch def
    [{[3 1 roll f {moveto}]}
     {[3 1 roll f {lineto}]}
     {[7 1 roll
       f 6 2 roll
       f 6 2 roll
       f 6 2 roll
       {curveto}]}
     {[{closepath}]}
     pathforall]
    newpath
    {aload pop exec} forall
    end
} def

/f {/y exch def
    /x exch def
    x y fsub 5 y mul cos mul
    y x fsub 3 y mul cos mul
} def

/fsub { % u = sin (a √(30 - (b^2 / 10))) * 460
    /b exch def
    /a exch def
    a 30 b dup mul 10 div sub sqrt mul sin 460 mul
} def

/setrandcolor { % def
    /r1 {rand 5 mod 3 div} def
    /r2 {rand 7 mod 6 div} def
    /r3 {rand 5 mod 6 div} def
    r1 r2 r3 setrgbcolor
} def

1 1 20 { % for

    /n exch def

    newpath
    /ShowcardGothic-Reg findfont 4 scalefont setfont
    -0.4 9 moveto (2018) true charpath
    -0.1 6 moveto (1820) true charpath
     0   3 moveto (2018) true charpath
    -0.1 0 moveto (1820) true charpath
    /f ctransform
    gsave

    clip
    newpath
    /j {
        /x exch def
        rand x mod x div 30 mul
    } def

    0 5 400 {
        /i exch def
        10 j setlinewidth
         setrandcolor
         0 i moveto
         300 i lineto
         stroke
     } for

     grestore
     currentlinewidth 2 mul setlinewidth
     0.1 0 0 setrgbcolor
     stroke

     3 410 moveto
     /Georgia-Bold findfont 5 scalefont setfont
     0.3 0.2 0.2 setrgbcolor
     n =string cvs show
     (/20) show

     showpage
 } for
2018 by Keiichiro Shikano on Scribd
今年は球体を作ってみたいなと思って、はじめはエッシャーふうの非ユークリッド空間の円盤への写像を「2018」のパターンで埋めようと思ったのだけど、ちょっと調べたら、それをやるには3つか5つの頂点を持つような「2018」をデザインしてそれを中心から外周へと再帰的に貼り付けていくことになりそうで、デザイン力が要求されるし、コードを書く時間もないから、やめ。 正方形を円へと等角写像で膨らませて輪郭を作りつつ、sinをとって膨らみ感を強調し、x軸で多少オフセットして、全体にそれっぽく見せることでごまかしています。
フォントはShowCard Gothicというボリューム感のあるフォントを選びました。
にしても、はじめてPostScript手書きで年賀状を作ってからもう10年になるのかあ。 ということで、これを機に過去のぶんもすべてGitHubにまとめておきました。
もともとPostScriptしばりというわけでもなく、なんとなく西暦の文字列を使って世界で1枚だけの年賀状をアルゴリズミックに生成するつもりしかなくて、2009年はPostScriptじゃないしコードも残っていなかった(Gaucheで書き捨てた)。 まあでも、よく10年続いたなと思う。
10年続きはしたけれど、年に一回しか書かないこともあり、PostScript力にはたいした進歩が感じられませんね。
2017/12/24
TeXでつくるMarkdownパーサ
この記事はTeX & LaTeX Advent Calendar 2017の24日めのために書きました。
TeXの中でMarkdownを書ける
先月のことなんですが、TeXの、TeXによる、TeXのためのMarkdownパーサをつくました。
- markdown-tex
https://github.com/k16shikano/markdown-tex
TeXで実装されてるので、当然、TeXで書く文書のなかで、シームレスにMarkdownを使えます。
具体的には、こんな感じに、\begin{markdown}から\end{markdown}のなかにMarkdown記法が書けます。
\documentclass{article}
\usepackage{md}

\begin{document}
\begin{markdown}

# markdown-tex

markdown processor in TeX.
As inline styles, `tt`, *italic*, and **bold** are available.

## subsection

Here is a enumerate list.

1. enumerate
1. in
1. the markdown way

This is an itemize list.

* this block
* will be
* itemized

And a quotation.

> Quote Somethin
> Really **Awesome**!

\end{markdown}
\end{document}
これをふつうにTeXで処理すると、記法から期待されるようなPDFができるわけです。

とはいっても、先月の時点でサポートしていた記法はそんなに多くなくて、これくらい。
- 行頭の「
#」の個数に応じた見出し化 - 行頭の「
*」で箇条書き - 行頭の「
<」でインデント - 行頭の数字で連番箇条書き
- 行頭スペース4個でインデントするとコードブロック化
`..`で囲むとインライン等幅*..*で囲むとインラインイタリック**..**で囲むとインライン強調
これ以外の要素を書きたかったら、いったん\end{markdown}して、生のTeXを書いてください。TeXなので、組版に関することなら、なんでもできます。
Markdownの中でTeXを書ける
この記事を読んでいる人はみんなTeX Conf 2017に参加しているので既知だと思いますが、念のため補足すると、このMarkdownパーサはTeX Conf 2017で発表した「TeXは軽量マークアップ言語の夢を見るか」のために作ったものです。 この発表では、Markdownをはじめとするマークアップ記法と、TeX(LaTeX)によって得られる表現力との関係について考察しました。 「Markdownについて話すのにMarkdownパーサの実装経験がなければ刺されるかも」という強迫観念から取り組んだ、概念実証のための実装です。
で、TeXのなかでMarkdownを使えるからといってうれしいことはあまりないし、それで済ませるつもりだったですが、せっかくTeXなので、先日ちょっと手を入れて\TeXくらいは生で書けるようにしました。
その副作用で、コントロールシーケンスや数式も入れられるようになりました!
# markdown-tex

markdown processor in TeX.
As inline styles, `tt`, *italic*, and **bold** are available.
Inline equation in \TeX notation $\int_0^1\frac{1}{x}dx = \infty$.

\hfill December 24 2017

## subsection

Here is a enumerate list.

1. enumerate
1. in
…

しかし、実はこれは誇大広告で、厳密にいうと2つの条件を満たすマクロやコマンドだけがMarkdown記法の中で使えます。
1つめの制約は、完全展開できる必要があるという点です。
たとえば、\sqrtは使えません。
これは、latex.ltxにおける\sqrtの定義では\@ifnextcharが利用されていて、そのなかでは展開されない\futureletが使われているからです。
なんで完全展開可能性が必要かというと、Markdown記法の構文解析を簡単にするために、対象となるトークンリストをいったん「完全展開された文字列」へと変換しているからです。
これにはexpl3の\tl_set_rescan:Nnxを使っています。
その際、TeXの入力を完全展開すると空白文字が集約されてしまってMarkdown記法として構文解析できなくなるので、これらは文字列とみなして完全展開しています。
\tl_set_rescan:Nnx \md_tokens
  {
    \char_set_catcode_letter:n {  32 }% SPACE
  } { \BODY }
これで\md_tokens変数に「完全展開された文字列」が入るので、それを構文解析し、それをTeXの胃袋に送ってPDFを作らせる、というのが先月までの実装でした。
そんなわけで、この状態でMarkdown記法の中に\TeXと書くと、このマクロが完全展開されたT\kern -..5ex\hbox E\kern -.\@mがそのままPDFに出てきてしまう状態でした。

では、Markdown記法の中に\TeXと書いて期待する出力結果を得るにはどうすればいいでしょうか?
完全展開をやめればよさそうですが、前述したようにスペースの扱いの都合があるので、文字列にしてからパースするという方針は変えがたい。
となると、完全展開された文字列をパースするときにTeXのプリミティブをパースしてコントロールシーケンスに変換し直し、それをTeXの胃袋に送ればいいのではないか?
というわけで、そんなようなコードを追加して、無事に\TeXのようなマクロがMarkdown記法のなかに埋め込めるようになりました。
\cs_new:Npn \inside_cs:Nnnn #1#2#3#4 {
  \tl_set:Nn \car_line { \tl_head:n { #4 } }
  \tl_set:Nn \cdr_line { \tl_tail:n { #4 } }

  \tl_if_head_eq_charcode:nNTF { #4 } { \sp_letter }
     {
       \tl_put_right:Nn #2 {
         \cs:w #3 \cs_end:
       }
       \exp_args:NNnff \parse_to_end_line_with:Nnnn { #1 } { #2 } { } { \cdr_line }
     }
     {
       \tl_set:Nx \so_far { #3\car_line }
       \exp_args:NNnff \inside_cs:Nnnn { #1 } { #2 } { \so_far } { \cdr_line }
     }
}
ただし、実装をサボっているので、非標準的(?)な利用方法のコントロールシーケンスはパースできません。
たとえば、\hbot{foo}はいいけど、\hbox to 10pt{foo}とかはだめ。
これがもう1つの制約です。
今回のオチ
にしても、ここまでにやったことを振り返ると、事実上TeXでTeXをパースしているわけで、むだなことをした感が半端ない……。
- TeX記法の入力をTeXでパースし、トークンリストが作られた(TeXの仕事)
- トークンリストをMarkdown記法としてパースするために、完全展開して文字列化した(
\tl_set_rescan:Nnx) - その文字列からコントロールシーケンスを取り出すのに、あらためてTeX記法のパーサを実装に追加した(
\cs_new:Npn \inside_cs:Nnnn)
2017/12/23
なぜ原稿をテキストで書かなければいけないのか
これは編集とライティングにまつわるアレコレ Advent Calendar 2017の23日めの記事です。
原稿をどういう形式・記法で書くべきなのか、という質問をときどき受けます。 一瞬だけ悩むけど、だいたい答えはこうなります。
「記法はなんでもいいけど、できればテキスト形式で」
今日は、この答えの背景を話します。
まずは「なんでもいい」の部分から。
記法はなんでもいい
出版社や編集者によっては細かく原稿の記法を指定しているようですが、ぼくは特に原稿の記法を決めていません。 これは、そういう記法を決めることができずにここまできた、というのが正直な理由です。 つまり、ぼくの怠慢なんですが、なにも考えずに怠慢であったというよりは、積極的に怠慢になろうと考えた結果なので、そのへんを少し吐露してみます。
原稿の記法を決めるということは、執筆者の脳内にあるものを吐き出してもらうための形を決めるということです。 脳内にあるものを他者に見せるための形を決めるわけではありません。
しかし、書き手が脳内を吐き出すという行為には、「どう見せたいか」という書き手自身の気持ちがどうしても混ざります。 この、「どう見せたいか」っていうのは、書く内容に合わせて思いつくものだったり、文章化が難しいから逃げるという側面もあったりするので、書く前から全パターンを網羅しきれるものでもありません。
で、脳内にあるものを吐き出した原稿と呼ばれる何かを、読者向けの見せ方を意識しながら整理する、そんな専門職があります。 編集者っていうんですけど、編集者によっては「あるドメインの読者にとってうれしい見せ方」から「適切な吐き出し記法」を逆算し、それを自分のキャリアのどこかの時点できちんと整備して、知見として執筆者と共有できている人がいます。 ぼくはそれをサボってきたので、そういう知見をとくに提供できず、「なんでもいいです」という頼りない返事になってしまうというわけでした。
ただし、ここからが重要なんですが、考えなしに「なんでもいいです」といっているわけでもありません。 言い訳っぽいですが、吐き出し記法に付随する見え方のほうを意識して見え方に頼った書き方をしてしまったり、汎用のブロック要素を利用した見せ方に依存する書き方が生み出されたり、そういうのを繰り返した結果として、「原稿の記法はあらかじめ決定しないほうがうまくいく」となって現在に至っています。 適切な吐き出し記法をいろいろ考えた結果、適切な吐き出し記法を汎用化すると(少なくともぼくには)うまくいかない、というジレンマに陥ったわけです。 ポジティブにいうと、好きな記法で吐き出してもらうのが執筆者とぼくにとって楽なケースが多いと判断したということです。
できればテキスト形式で
すでに結論めいたものを書いてしまってますが、どう見せるかの検討に移ってよいのは、脳内にある概念をとりあえず文字列として吐き出し、それを文章にして、さらに段落としてしっかり構成したあとです。 もうちょっと正確にいうと、段落の構成を試行錯誤するのと並行して、ようやく見せ方を考えられるようになります。
こんなふうに言うと、「はじめに構成をかっちり固めてから書くんじゃ」という声が聞こえてきそうですが、怒られを恐れずにいえば、それは幻想です。 文章を書く前から段落の構成をかっちり固めるには、相当の訓練とあきらめが必要です。 むしろ、文字列をダンプしたものから段落を試行錯誤して練り上げることこそが、文章作成の王道だといえるでしょう。
原稿がテキストであることが重要なのは、これが主な理由です。 文字列、文章、段落を行ったり来たりするイテレーションを、コンピュータを使って回しまくるには、テキストデータがいちばん好都合なのです。 だから、テキストで書いてください。
さらに、テキストとして吐き出されていれば、編集者が文章や段落をつくる手伝いができます。 テキストであればどの環境でもエディタで編集できるから、という面もありますが、もっと大きいのは、テキストであれば差分をとったりバージョン管理システムを利用したりすることで、編集者の作業を執筆者から見て透明にできるからです。
脳内にある情報を原稿として吐き出すのは、たいへんです。それをさらに文章や段落にするのも、けっこうたいへんです。 だから、後者のほうを手伝う職業として、編集がいるわけです。 しかし、原稿から文章や段落にする過程で、原稿のポイントが失われたり、もともとの執筆者が意図していない情報が紛れ込んだりするのは問題です。 この過程では、「編集者がやったこと」がつまびらかになっている必要があります。 つまり、編集者の作業が執筆者にとって透明である必要があります。 それがコンピュータで不自由なくできるのも、いまのところテキスト形式だけなので、その点でも原稿はテキストにしたいという結論になります。
原稿はソースコード、組版結果はバイナリコード
前述したように、原稿をテキスト形式で書き出し、テキスト形式のまま編集することは、編集者の作業の透明性を高めます。 編集者の作業が透明であるということは、作業結果がすべて執筆者の手元で再現できるということでもあります。 しかも、バージョン管理システムを使えば、元の原稿に対する差分(の積み重ね)という形で再現できます。
これは、執筆者が自身の吐き出した原稿をソースコードとして保持し、そのゆくすえを終始自分の管理下におけるという意味でもあります。 わりと見逃されてる点だと感じてるんですが、「原稿を人に見せる形にまで加工するプロセスが、原稿に責任がある本人にとってアンタッチャブルな状態」って、書き手にとっても編集する側にとっても、けっこう怖くないですか? データとしてアクセスできなければ、どこがどう変わったかをgrepしたり、あとで気づいた用語の間違いを全体にわたって機械的に変換したり、そういう作業が死ぬほどめんどくさくなります。 気に喰わない文章や段落を試行錯誤して手直しすることも、気軽にできなくなってしまいます。 少なくとも、あとは版面に情報を適切に固定するだけという状態になるまでは、編集者はいうまでもなく執筆者自身も原稿にアクセスできるほうがいいはずです。
原稿に責任がある人が、原稿への計算機によるアクセスを奪われないためには、そもそも原稿がそれにかなった形式である必要があります。 その形式として妥当なのは、テキストでしょう。 執筆者にもDTPアプリケーションを執筆に使ってもらう、もしくは、執筆者が利用できるワープロソフトで組版もするという可能性もありえなくはないですが、こうした方法は先に言及した「適切な吐き出し形式」に似たジレンマに陥ります。 「こう見えてほしい」という気持ちを前提にして吐き出しをすると、しっかりした文章や段落を構成するのが困難になるのです。 書いている最中に見せ方を工夫したくなってしまうのは、早すぎる最適化の罠だといってもいいでしょう。 まして、WYSIWYG環境で書くのは、バイナリコードを直接いじっているようなものです。 (そもそも、見た目の先にある組版という専門性が要求されるプロセスに、非専門家が手軽に介入できる状態はどうなのかという問題もあります。 原稿がどう見えてほしいかと、その要求をどう実装するかには、さらに一段階ギャップがあるのです。)
なんだか、ドキュメントにおける構造とスタイルの分離という、よくある話に収斂しているような気もしますね。 実際、気のせいじゃありません。 この記事で言いたかったことを、構造とスタイルの分離という話に翻訳すると、次のように要約できます。
- ドキュメントの構造となる部分の試行錯誤では、テキスト形式を使うのが作業面でもっとも理にかなっている
- ドキュメントの構造となる部分は、原稿に責任がある人から最後までアクセスを取り上げるべきでない部分でもあり、それに都合がいいのはテキスト形式である
なお、この記事の趣旨は「執筆や編集にはテキストエディタが最高」ではないので、べつにWordとかGoogle Docs、あるいはIDEなどを執筆や編集に使ってもぜんぜん問題ないです。 ただし注意が必要なのは、それらツールにネイティブな形式(.docとか)をソースにしてしまうと、ここに挙げたようなテキストであることの利点が生かせないということです。 なので、どんなツールで書くにしろ、どこかの時点ではテキスト形式にして、それを最終的なソース原稿とするのが無難だとおもいます。
記法が決まらないと前に進めないならMarkdown的なやつで
というわけで、文章を書くときは、「とにかく脳内をダンプし、試行錯誤して段落を組み立てる」のが基本です。 繰り返しになりますが、脳内を吐き出すときの記法は、どう見えてほしいかという気持ちに無意識に依存してしまいます。 その依存を断ち切り、どう見えてほしいかはいったん忘れて文と段落の構成に集中するというのが、一次脱稿でいい状態にもっていくコツ(はやく脱稿するコツではない)です。 「段落だけを書く」という覚悟で望みましょう。 どんな本にも適用できる決定版の見せ方はないけど、万能の書き方というのは実はあるので、パラグラフライティングをしっかりやってください。
とはいえ、そうはいっても脳内を吐き出すときの記法に何かしら制約があるほうがいいっていう人も少なくないと思います。 段落だけとかストイックすぎて無理、見出しの指定方法やインラインの強調方法とか決まってないと書けない、とくに技術書ではコードブロックや図も入れたい、という要求は当然ありますよね。
そんなときは、とりあえず、Markdownふうの記法を使っておきましょう。 ここで、CommonMarkか、それともGitHubFlavoredか、といったことを気にする必要はありません。 見ためを確認したり、そこからワンパスでHTMLやPDFを生成することが目的ではないからです。 ちょっとしたブログ記事ならともかく、どんなMarkdown方言であれ、どのみちMarkdownだけをソースにして本は作れません。 Markdownだけで本が作れたら、XMLとかLaTeXとかとっくに滅んでますね。
まとめ
この記事では、なぜ自由な記法のテキスト形式が原稿の執筆と編集で優位性があるかについて、下記の2点に注目して主張しました。
- どう見せるかは考えず、段落の書き込みに集中するためには、見せ方と表裏一体な記法には惑わされないほうがよい
- 内容に責任をもつ著者や編集者が、自分たちには手が出せない状態になる直前まで計算機を使って原稿を操作するには、データ形式としてテキストが好都合
そのうえで、これらの要求を満足するならツールはテキストエディタでなくてもよいこと、シンプルな段落以外の要素として脳内をダンプする手法としてのMarkdownふう記法の可能性について考えました。
Markdownについては、また明日なにか書くかもしれません。
2017/12/06
英語圏のIT系技術書ブランドについての雑感
この記事はpyspa Advent Calendar 2017の6日めのために書きましたが、アマゾンアソシエイト目的です。
『退屈なことはPythonにやらせよう』が出た
2017年にブレイクしたPythonの本といえば、オライリー・ジャパンから発行された『退屈なことはPythonにやらせよう』ですよね。
実はこの本、そのむかし、自分でも翻訳発行をひそかに検討していたのです。 当時の翻訳者候補の方とのDMをさかのぼってみたら、少なくとも2015年7月以前の話でした。 「非プログラマーでもプログラミングしようぜ」という趣旨で著された本書は、わたし自身の書籍企画の方向性によくマッチしていました。 それで本書に目を付けたのですが、いかんせん分量は多いし、Pythonは日本だと入門者向け言語としていまいち盛り上がらないし(当時の話です)、なにより例題があんまりぐっとこないねという話で、そのときは企画化をパスするという結論を出しました。 これは余談にして重要なポイントでもあるんですが、それから起きた出来事を思うと、このとき本書を自分が企画化しなかったのは別の意味でも正解でした。
それから数年たち、Pythonブームという絶好のタイミングで本書が日本語化され、たくさんの人に読まれるに至ったのは、掛け値なしにとてもうれしいことです(ほんとだよ)。 逃がした魚は大きい的な気持ちもないではないですが、ぶっちゃけると、オライリーという看板で出たことが本書の日本での普及にとってとても大きなことだったと思います。
さて、ここで「アレ?」と思う人がいるかもしれません。 「この本はオライリーなのに、オライリーの編集者じゃないおまえが企画を検討してたって、いったいどういうこと?」
オライリーの本はO'Reillyの本とは限らない
『退屈なことはPythonにやらせよう』の原書は、O'Reilly Mediaではなく、No Starch Pressという北米の出版社による発行です。
この出版社の名前を聞くのは初めてという人でも、コンピュータ書に関する情報を気にしている方なら、その発行タイトルのなかには知っているものが少なからずあるでしょう。 No Starch Press発行の本で翻訳されているものを、思いつく限りざっと並べてみます(もちろん全部ではありません(たぶん))。
- 『退屈なことはPythonにやらせよう』
- 『すごいHaskellたのしく学ぼう! 』
- 『Land of Lisp』
- 『すごいErlangゆかいに学ぼう! 』
- 『Rubyのしくみ』
- 『たのしいプログラミング Pythonではじめよう! 』
- 『プログラマの考え方がおもしろいほど身につく本』
- 『サイバーセキュリティプログラミング』
- 『Hacking: 美しき策謀』
- 『Pythonからはじめる数学入門』
そうそうたるラインナップですよね。 さらに面白いことに、No Starch Pressは『マンガでわかる統計学』などの英語版の出版社でもあります。
- 『The Manga Guide to Statistics』
- 『The Manga Guide to Linear Algebra』
- 『The Manga Guide to the Universe』
いまではこんなにすごいNo Starch Pressですが、もとはBill Pollockという人が立ち上げた小さな出版社でした。 2006年にBillさんに会ったころもまだまだ小さい出版社でしたが、この10年くらいで一気に魅力的なラインナップを増やし、いまではIT系技術書界隈でかなりの存在感を示しています。 ここでまた余談だけど重要なポイントとして、2006年にBillさんに『マンガでわかる統計学』の版権買ってよという話をするとき、「エディターです」と自己紹介したら、「おれはパブリッシャーだぜ」と冗談で返されたのが自分のなかではものすごい衝撃で、いつかおれもパブリッシャーって名乗るぞとぼんやり思ったのでした (もっともBillさんはぼくのことさえ覚えてない気がする)。
話をもどすと、上記のNo Starch Pressの翻訳書のなかには、『退屈なことはPythonにやらせよう』以外にも、いくつかオライリー・ジャパン発行のものが含まれています。 つまりオライリー・ジャパンから発行されている翻訳書は、必ずしも世界的な技術書ブランドであるO'Reilly Mediaのタイトルだけではないのです。 オライリー・ジャパンの中の人は、No Starch Pressをはじめ、さまざまな海外の出版社からこれはと思う良タイトルをO'Reilly Mediaに限らず探してきて翻訳発行しているわけです。 これぞO'Reillyというカバーだけど動物の版画でない本がけっこうあるのは(宇宙人までいる)、そういうわけなのです。
No Starch Press以外で、日本ではO'Reillyブランドの技術書として誤認されてるんじゃないかなと感じてる本としては、たとえばこんな例があります。
- 『コンピュータシステムの理論と実装』
- 『SQLアンチパターン』
- 『Go言語によるWebアプリケーション開発』
- 『シングルページWebアプリケーション』
- 『入門 React』
- 『Effective Python』
上記6点は、すべて原書出版社がちがいます。当ててみよう。(Hayao(-ε-δ) さんに教えていただいたのでアソシエイト効果がありそうなほうを追記しました。Hayao(-ε-δ) さんありがとうございます!)
なお、逆のパターンである「O'Reillyの本がオライリーから出ているとは限らない」も真です。 ただし、最近はO'Reilly Mediaのラインナップの魅力が落ちてるのと、O'Reillyブランドで魅力的なのはオライリー・ジャパンがしっかり出してくるので、ほぼオライリー・ジャパンから出てきているように見えます。
動物だけではない英語圏の技術書ブランド
ここまで長々とアマゾンアソシエイトを張りまくってきましたが、ここからが本記事のタイトルでもある「雑感」です。
2017年現在の英語圏におけるIT系出版社のブランド地図は、たとえば2000年代前半のそれとはかなり変動しています。 2000年代前半は、その当時で創業20年くらいのイケイケO'Reilly Mediaに圧倒的なブランド力がありました。 しかし現在は、この記事でも一押しのNo Starch Pressはじめ、やはり中堅どころのManning Publicationsなど、現時点で創業20年前後を迎えている中小の出版社のほうがむしろ精力的に面白い書籍を生み出している印象があります。 彗星のごとく登場してあっというまに手堅い出版社となったPragmatic Bookshelfも、これから創業20年前後にかけて、もうひと化けするかもしれません。
そうした出版社に比べると、すでに40年近い歴史を持つO'Reilly Mediaは、経営規模で見ても大手出版社として網羅的なラインナップを擁し、中小出版社の書籍の発売元として流通を支える存在にまで成長していますが、発行書籍の面白さとかクオリティという点では最近ぱっとしないなというのが率直な感想です。 それに呼応するように、いま企画が好調なオライリー・ジャパンが、少なくとも翻訳書についてO'Reillyタイトル依存でなくなっているというのは感慨深いところです。 そういえばオライリー・ジャパンも、いまちょうど創業20年ちょっとですね。
一方、O'Reilly Mediaよりさらに老舗のPearsonや、そのハイエンドコンピュータ書籍のレーベルとしてのAddison-Wesleyは、タイトル数こそ多くないですが、IT系技術書出版社としての信頼感はいまなお顕在だなあと感じることがわりとあります。 タイトルに対する信頼感という意味では、The MIT PressやCambridge University Pressなどの大学出版系も依然として強くて、これからも日本語で読めるようにしていくべきだと思えるような本はこのへんの老舗出版社のものがますます多くなるのかも、と思っています。
精力的といえば、英国を拠点に爆発的にラインナップを増やして一気に存在感を増したPacktという出版社もあります。 Packtの特徴は、とにかく最速であらゆるIT系のトピックについて書籍の形をしたものをそろえるという戦略です。 そうしたラインナップ網羅主義は、ある意味ではO'Reilly Mediaが目指してきたところだとも思います。 ラインナップ網羅主義には、個別のタイトルの出来不出来をケアできないという面があるので、個人的には避けていきたい方向性ですが、いかんせん展開が速いので、Packtの傾向にも注目だけはしていこうと思っています。
今回のオチ
日本語圏におけるIT系技術書の状況については、あまり大きなことを言える立場にないですが、いろんな人たちの紆余曲折とか踏ん張りとか地道な出版活動とかあって、いろんなブランドが盛り上がったり、消えたり、地に落ちたり、新しく誕生したりしています。
そんななかで、この記事をここまで読んでアマゾンアソシエイトを踏まなかった方には、2017年に4つのタイトルを発売して始動したラムダノートというIT系技術書出版社の名前を覚えてもらえるとうれしいです。
2017/12/03
TeXでつくる『RubyでつくるRuby』
この記事はTeX & LaTeX Advent Calendar 2017の3日めのために書きましたが、宣伝目的です。
TeX & LaTeX Advent Calendar 2017の重点テーマは「TeXでつくるアレ」とのことですが、偶然にも2017年、よく似たタイトルの『RubyでつくるRuby』(遠藤侑介著)という本が出ました。 プログラミング言語を学ぶときの例題としてプログラミング言語をつくる以上に格好のネタはない、という趣旨の本です。

プログラミング言語をつくるというと、なにやら難しく聞こえるかもしれませんが、『RubyでつくるRuby』では、わずか150ページのなかにそのエッセンスを凝縮しています。 本文の理解を助けるかわいらしいイラストもフルカラーでふんだんに用意されているので、はじめてプログラムを書いてみようかなという人でも、おそらく(願わくば)読み通せる内容です。 電子書籍はなく、古き良き紙の本のみですが、電子版がいいという人はAscii.jpでもとになった連載が読めるので、そちらをどうぞ!
プログラミング言語の処理系が扱うデータは「木」
『RubyでつくるRuby』では、プログラミング言語Rubyで書かれたプログラムを処理して実行するプログラミング言語を、プログラミング言語Rubyでつくります。 つまり、本書の読者が書くことになるプログラムが処理するのは、Rubyのプログラムです。
Rubyに限りませんが、多くのプログラミング言語では、プログラマーが書いたプログラムを実行する前に、そのプログラムをまず「木」と呼ばれる種類のデータへと変換します。 この「木」は、その名のとおり樹木のような姿をしていて、「枝がのびる節」と「葉」があります。
このへんは、文章で説明するよりも、絵で見るほうがはやいでしょう。 たとえば、次のようなRubyのプログラム(四則演算だけですが)がどんな木になるかというと……
(1 + 2) / 3 * 4 * (56 / 7 + 8 + 9) こんな木になります。式で見るより、項どうしの演算の関係がわかりやすいですね。

本書の解説には「木」を扱う場面がたくさん出てくるので、説明文やコードに加えてこんな具合に木の絵をたくさん用意できれば、いま説明しているデータの姿がどんなようすなのか「ひとめ」でわかります。 なので、ぜひ木の絵はたくさん載せたい。
かといって、こういう木の絵をぜんぶイラストレーターさんに描いてもらうのもたいへんです。 描くほうだけでなく、間違ってないかチェックするほうもめんどくさい。 それなりの見た目で、なおかつ間違いなくプログラムの木を描くには、どうすればいいでしょうか?
そう、TeXを使えばいいのです。 実際、上に例として出した木もTeXで生成しています。
TeXで木を描く
というわけで、前置きが長くなりましたが、『RubyでつくるRuby』の木の絵をTeXでどう描いたかをちょっと紹介します。 書籍『RubyでつくるRuby』では、プログラムの木を、Rubyにおける配列表現からTeXで生成しました。 これなら手間もかからず、なにより作図にともなう間違いもありません。
tikz-qtreeパッケージの使い方
木は、プログラムに限らずいろいろな場面に出てくるデータ構造なので、関連するTeXパッケージがわりとたくさん出そろっています。
そのなかで『RubyでつくるRuby』の木を描くのに選んだのは、 tikz-qtree というTikZベースのパッケージです。
https://ctan.org/pkg/tikz-qtree
この tikz-qtree パッケージを選んだ理由のひとつは、上下逆向きの木構造を手軽に描けることです。
木構造を描くときは、根を上にする(つまり本物の樹木でいったら上下逆)ことが多いのですが、本書の場合にはイラストにある本物っぽい木の絵とシームレスに読み替えてもらいたいので、根を下にして木構造を描ける機能が重要だったのです。
tikz-qtree のミニマルな例を示します。これは 2 * 4 というRubyプログラムの「木」の例です。
\documentclass[tikz,convert={outext=.png}]{standalone}
\usepackage{tikz-qtree}
\begin{document}

\begin{tikzpicture}
  \Tree [.*
          [2
           \node[draw]{4};
          ]]
\end{tikzpicture}

\end{document}
\Tree[ ] のなかに、木を描いてきます。
[ ] を入れ子にすると、その中に書いたものが子どもの要素になります。
要素としてスペース区切りで値を書き込めば、それが葉になります。
子を持つ要素には、値の前に「 . 」をつけます。
上の例では、根にあたる「 * 」に「 . 」が必要です。
さらに上の例では、TikZの \node 命令がそのまま使えることを示すために、「4」のほうだけ枠をつけてみました( \node 命令なので末尾に ; を忘れずに!)。
上記を tree.tex として保存し、以下のようにpdflatexで処理すれば……
$ pdflatex --shell-escape tree.tex こんな絵が得られます。

この木の上下をさかさまにするには、 tikzpicture 環境に [grow'=up] というオプションをつけるだけです。
\documentclass[tikz,convert={outext=.png}]{standalone}
\usepackage{tikz-qtree}
\begin{document}

\begin{tikzpicture}[grow'=up]
  \Tree [.*
          [2
           \node[draw]{4};
          ]]
\end{tikzpicture}

\end{document} 
このままだと絵として味気ないので、色をぬったり、枠の形を変えたり、線の幅を調整したりするわけですが、そのへんはTikZの \node をごにょごにょいじるというつまらない話なので割愛します。
TikZのマニュアル(むかしは400ページくらいでしたが、いまでは1000ページ超)を片手にがんばってみてください。
TikZソースを木のソースから生成する
木の見た目を整えたら、毎回TikZを手描きするのはばかばかしいので、プログラムで生成するようにします。 『RubyでつくるRuby』で描きたいのはプログラムを表す木で、その木はRubyコードとしてはこんなふうな姿をしています。
["*", 2, 4] 本当は、 2 とか 4 が何ものであるかを表すために、もうちょっとメタ情報がついていますが、だいたいこんな感じです。
(そもそも、配列でプログラムの木を表すのはあくまでも『RubyでつくるRuby』の中に限定した話で、じっさいのRubyではまったくべつの表現方法です。)
これはどう見てもS式なので、カンマを削除してGaucheで直接読み込んで変換し、 tikz-qtree パッケージを使った木を描くTeXソースを吐くようにしましょう。
(use srfi-13)
(use text.tree)

(define (deco-b b)
  #"\\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\\small ~b};")

(define (deco-l l)
  #"\\node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\\mystrut\\smash{~l}};")

(define *before-tikz* "\
\n\\begin{tikzpicture}[grow'=up] \
\n  \\tikzset{ \
\n    every tree node/.style={font=\\ttfamily\\large}, \
\n    edge from parent/.append style={very thick}} \
\n  \\Tree ")

(define *end-tikz* "\n\\end{tikzpicture}\n\\clearpage\n")

(define *before-doc* "\
\n\\documentclass[tikz,border=10pt,convert={outext=.png}]{standalone} \
\n\\def\\mystrut{\\rule{0pt}{1.3ex}} \
\n\\usepackage{tikz} \
\n\\usepackage{tikz-qtree} \
\n\\usetikzlibrary{shapes.geometric,shadows}% \
\n\\begin{document}\n")

(define *end-doc* "\n\\end{document}\n")

(define (tikzqtree ts)
  (list *before-tikz* (mkqtree ts) *end-tikz*))

(define (mkqtree ts)
  (cond ((null? ts) "")
        ((pair? ts) (mkbranch
                      (car ts)
                      (map mkqtree (cdr ts))))
        (else (mkleaf ts))))

(define (mkbranch b l)
  (list "[." (deco-b (x->string b)) "\n " l "]"))

(define (mkleaf l)
  (list (deco-l (x->string l)) " "))

(define (main args)
  (call-with-input-file (cadr args)
    (lambda (p)
      (print
       (tree->string
        (list
         *before-doc*
         (map tikzqtree (port->sexp-list p))
*end-doc*)))))) カンマをプログラムで削除しないのは、カンマなしならS式としてそのままreadできるからです。この手のユーティリティはコーディングが簡単なほうに倒してガッっと書いてしまうのが肝要だと思います。
実行結果
最初に紹介した、わりと複雑なかっこうをしている次のようなRubyの計算式について、プログラムの木を描いてみましょう。
(1 + 2) / 3 * 4 * (56 / 7 + 8 + 9) この計算式は、『RubyでつくるRuby』ではこんな感じの木(配列の配列)として表されます。
["*", ["*", ["/", ["+", 1, 2], 3], 4], ["+", ["+", ["/", 56, 7], 8], 9]] この一行をファイルに保存して、カンマだけエディタで削除し、先ほどのGaucheスクリプトで読み込むと……
$ gosh mktree.scm temp.rb > temp.tex こんな気持ちの悪いLaTeXのソースができます。
\documentclass[tikz,border=10pt,convert={outext=.png}]{standalone}
\def\mystrut{\rule{0pt}{1.3ex}}
\usepackage{tikz}
\usepackage{tikz-qtree}
\usetikzlibrary{shapes.geometric,shadows}%
\begin{document}

\begin{tikzpicture}[grow'=up]
  \tikzset{
    every tree node/.style={font=\ttfamily\large},
    edge from parent/.append style={very thick}}
  \Tree [.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small *};
 [.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small *};
 [.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small /};
 [.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small +};
 \node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{1}}; \node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{2}}; ]\node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{3}}; ]\node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{4}}; ][.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small +};
 [.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small +};
 [.\node[text=white,inner sep=4pt,drop shadow,fill={rgb:blue,5;white,1;green,1},draw,rounded corners]{\small /};
 \node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{56}}; \node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{7}}; ]\node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{8}}; ]\node[text=white,inner sep=2pt,drop shadow,fill={rgb:green,6;white,1;black,4},draw,ellipse]{\mystrut\smash{9}}; ]]
\end{tikzpicture}
\clearpage

\end{document}
これをコンパイルすると……
$ pdflatex --shell-escape temp.tex 冒頭に掲載したような、こんなきれいなpngファイルが得られるというわけでした。

まとめ
『RubyでつくるRuby』を読むと、このような「木」がプログラムそのものだということがわかります。 このように生成された図だけでなく、hirekoke画伯描きおろしカラーイラストも豊富に掲載された『RubyでつくるRuby』をいますぐ買おう!
繰り返しになりますが、電子版はラムダノートでは出版していないものの、Ascii.jpでもとになった連載が読めます。ぜんぶ無料!
2017/08/21
LLイベント2017の「第2プログラミング言語鑑定団」で鹿野が話したことまとめ
プログラミング好きにもいろいろあって、仕事で使ってる道具をもっと知りたいという人もいれば、自分が使ったことない道具の話を知りたいという人もいれば、道具はなんでもいいから面白い話がしたいという人もいます。 久しぶりに参加したLLイベントは、そんな多様なプログラミング好きが「全員がアウェーな立場」で交流するという、貴重で面白い機会でした。 実際、「LL」の1つめのLには去年までは「Lightweight」という意味があり、その単語が示す特徴をもった言語のイベントのようにどうしても見えてたんですが、今年からはそういう区切りも公けになくし、Lは「Learn」の意味になったとのことです。
そのLLイベント2017で、「第2プログラミング言語鑑定団」というセッションに出させてもらいました。 司会の小山さんが「Teratail, Yahoo知恵袋などから、それらしい質問をかき集めてマージ」した6パターンの「次に学ぶ言語は何がいい?」に対し、鑑定団の一人としてお勧め言語を紹介せよというのがミッションでした。 ぼく以外の鑑定団のメンバーは、ささけんさん、高野さん、高橋さん。一癖あるすごいITエンジニアばっかりだー。このメンバーが集まるというだけで、LLイベントすごいって気持ちになりました。
いっぽう、ぼく自身はただの書籍編集者です。 自分の仕事に必要な道具を作ったり環境を整えたりはするけどエンジニアというわけではないし、プログラミングは好きで勉強はするけど研究者ではないし、 本職ではない人間になんという無茶ぶりかと思って最初は躊躇したのですが、たぶん、この記事を書かせてもらったことをきっかけに声をかけてもらえたんだろうなあ。
なお、上記の記事は「ElixirとRustとHaskellにちょっと興味がある人向けの紹介記事を各界の第一人者に書いてもらおう」という企画の前フリなので、そういう目線でやさしい気持ちで読んでもらうと幸いです。 ElixirとRustはすでに公開中。今月中にHaskellも公開される予定です(宣伝)。
ほかの鑑定団の回答
そもそもブログで自分の回答を書くつもりはなかったんですが、ささけんさんがさっくりと自分の回答をまとめて公開したので、まとめざるを得なくなった。
[高野さんと高橋さんが何か公開されたらリンクはる予定地]
鹿野はどんな言語を勧めたか
想定質問は事前に見せてもらってたのですが、じゃあその質問に対して何を答えることが求められてるんだろうというのは、正直なところ当日になってもわからなくて、会場に着くまでは「ちょっとまずいかもなあ」と暗い気持ちでいました。 で、それを一緒に来ていた同僚に愚痴ったところ、「お勧め本を紹介したらいいじゃん」という画期的な入れ知恵をしてもらい、その路線でいくことに決めたのでした。
質問1
文系の大学4年生のときにプログラミングが好きになり、独学で C と Java の初歩を学びました。卒業後Web 制作会社に入社し、HTML, CSS,JavaScript を習得しました。Web周辺だけでは将来が不安なので、次に何を学ぶべきか考えています。アドバイスをいただけないでしょうか。
この質問を最初にみたときは「知らんがな」という思いしか去来せず、サイコロでも投げて決めろと言いたかったのですが、言語じゃなくて書籍であれば紹介すべきものがすぐに思いつきました。 五十嵐先生の『プログラミング in OCaml』です。なので、回答は「OCaml」にしました。
あらかじめ断っておくと、ぼくはOCamlを実用してるわけではありません。 OCamlのコードをいじったのは、『型システム入門』を作ったとき、OCamlで書かれた原著者ビルド環境を日本語pLaTeX向けに改修したときくらいです。 ですが、この本は、OCamlを使うつもりがとくにない人でも、独力でプログラミングを学んできたような人であれば、読むといいことがたくさん書いてあると思っています。 具体的には、OCamlというプログラミング言語でのプログラムの書き方だけでなく、どうしてそういう機構になっているのかがいちいち詳しく解説されており、プログラミング言語の理論についても味見できるようになっています。 この質問者はWeb周辺の技術を追いかける以外の勉強をしたいようだし、そういう意味でもぴったりではないかと思いました。
質問2
文系大学に通う学生ですが、昔からゲームが好きで、将来はゲームクリエイターになりたいと考えています。そうはいってもプログラミングはまだできないし、特筆したスキルもありません。ゲームクリエイターに関する書籍を読んで、将来こんなゲームを作りたいと夢を膨らませています。私がゲーム開発者になるためにはどの言語から学ぶのがよいでしょうか?
ゲーム作りたいといってる時点で、プログラミング言語を選んでる場合じゃなく、むしろどのゲームエンジンを使ってみればいいかという話なんですよね。 なので、回答は「Unity」か「Unreal Engine」にしました。
書籍として紹介したのは、『Unreal Engine 4で極めるゲーム開発』です。無責任にも自分では読んでないんですが、渋川さんが激烈に勧めているので間違いないでしょう。
質問3
Web制作会社でサーバサイドを開発しているソフトウェアエンジニアです。現在使っているプログラミング言語はRubyでフレームワークはRailsです。最近世の中でAIや機械学習がブームになっていて、私もそちら方面のスキルを磨いてより高度な作業をできるようになりたいと考えています。AIや機械学習を使いこなすのに最適なプログラミング言語は何でしょうか?
機械学習で縛られてる設問なので、Pythonからは逃げられないような気がします。ということで、回答としては「Python」。
でも、たぶんPythonを学べばどうなるものでもなく、線形代数なんかを地道に復習したほうがいいような気もします。 そのへんからかみ砕いて解説されているという点で、書籍は『ゼロから作るDeep Learning』をお勧めにしました。
質問4
SIerとして大手案件の2次下請けを仕事にしています。主に使っている言語はJavaでフレームワークはStrutsです。噂ではStrutsにもSIerにも未来はもう無いそうで、転職して他の仕事もできるようになりたいのですが、これまでJavaしか使ったことがないのでどうしたら良いか分かりません。これから学ぶのならば、なるべく長く役に立つ技術が良いと思うのですが、何がよいでしょうか。
「長く役に立つ」といったら、これまで長く使われてきた実績があり、これからもそう簡単に消えることはないであろう言語しかないだろうということで、「Common Lisp」か「Haskell」と回答しました。
書籍はそれぞれ『実践Common Lisp』と『すごいHaskell』を紹介。このへんは我田引水させてもらいました。
質問5
プログラミング初心者です。Webサイト作成のためにPHPの学習中ですが、他の言語にも興味があります。しかしなかなか難しいのもあって効率的なプログラミング学習法はないかと頭を悩ませているところです。そこで、おもしろそうと興味を持てば学習がはかどるのではと考えました。面白いプログラミング言語とその理由を教えてください。
面白いプログラミング言語といったら、とりあえずこれを押さえておけということで、「Brainfuck」です。 とはいえ、Brainfuckでプログラムを書くんじゃなく、好きな言語でBrainfuckを作ってみたらという提案をしました。 やっぱり、プログラミング言語ってこういうことなんだという実感を得るには、なんでもいいから作ってみるのがいちばんで、そのためにもBrainfuckの実装には一度は挑戦してみると楽しいと思います。
というわけで、お勧めした書籍は『Rubyで作る奇妙なプログラミング言語』。
質問6
インフラ運用エンジニアをしています。使える言語はシェルです。仕事ではたくさんのOSSを使用していますが、これらは書かれている言語がC,PHP,Python,Ruby,Node.js,Javaなど多岐にわたります。最近は自動化がブームですが、OSSを使って自動化をやっていくために、どのような言語を学ぶのがよいでしょうか。
OSSのツールを利用していくのに知っておいたほうがいい言語で、質問に出ていないものといって思いつくものは、「Go」しかありませんでした。 というわけで書籍としては『プログラミング言語Go』です。
いま思い返すとPerlとかLuaという選択肢もありえましたが、やっぱりあの場でお勧めする言語としてはGoしかありませんでした。 なぜなら、Goはラムダノートから近日中に新刊が出る予定だからです。 アスキーjpで連載していた「Goならわかるシステムプログラミング」の書籍化です! 昨日のLLイベントでも「低レイヤをかじることの重要性」は何度か強調されていて、そのたびにCやアセンブラというキーワードが出ててましたが、いまならそれこそGoで楽に学べます。 そういう趣旨で好評の連載に、著者の渋川さんが少し話を追加して、10月くらいに出せるように頑張って制作中。お楽しみに(宣伝)。
質問7(会場からの飛び入り質問)
小学三年生の息子がプログラミングをはじめるのに、Scratchのほかにどんな選択肢がありますか?
小学生にプログラミングを教えるときって、ビジュアル言語じゃない形でコンピュータの開発環境に触れる機会も必要だと思ってるんですよね。 かといって、汎用言語はそこそこ覚えないといけないことが多くてつらい。 そこで、覚えることが最小限で、コンピュータの生っぽいところを意識できる言語があればいいんですが、その条件を満たす言語はSchemeくらいしかありませんよね(異論は認める)。 というわけで「Scheme」をお勧めしました。
参考書籍はもちろん『計算機システムの構造と解釈』です(いまおもうと『Scheme手習い』という手もあった)。
2017/06/21
編集というサービスの内容(技術書編)
- 原稿をDTP担当者が作業できるデータにする
- 誤字脱字、非標準的な表記を直す
- 表記を統一する
- 文法の間違い、不適切な言い回しを直す
- 構成の不備、内容の間違いを指摘する
- 構成の不備、内容の間違いを直す
- 冗長な内容、文脈から外れる記述を欄外に追い出したり、段落構成を手直ししたりする
- 段落や文を、文脈に合わせた相に書き直す
- 行間をうめる
- 解説画像やイラスト、索引などのメタ情報を作る
- 原稿を書く
- 【番外】企画する
どこまでやってほしいか、できるか、追加料金がいくら必要なのかというのを、著者・版元編集者・下請け編集者の間ではっきりさせると、みんなが幸せになる気がする。(だいたい編集外注するときって「編集作業一式」の「ページあたりの単価」になりがちで、しかしその「一式」には上記のような幅があるわけだから、人によって高いとか安いとか感じ方がいろいろ変わってしまうよね……。)
本として書店に並ぶまでに必要な作業は上記のほかにもいっぱいあり(装幀の企画と手配、権利、印刷製本、流通に関連するいろいろな仕事などなど)、上記に挙げた編集業務を担当編集者がぜんぶやるべきという話ではないはず。
たとえば、上記のうち5までは担当編集者が直接やるけど、残りは外部の査読者だったり編集者だったりを雇うことにするとか、あるいは、そこは著者の仕事であると最初から割り切る(ということを著者との間で同意しておく)ほうが、結果的に読者が手にする本にとって最善というケースもあるかもしれない。
なお、弊社では上記のすべてに対応した編集業務の受注が可能です。お気軽にご相談ください。
2016/12/30
2017年賀状
年賀状書いた。
%!PS
<< /PageSize [285 420] >> setpagedevice

/setrandcolor {% def
    /r1 {rand 5 mod 3 div} def
    /r2 {rand 4 mod 4 div} def
    /r3 {rand 3 mod 4 div} def
    r1 r2 r3 setrgbcolor
} def

/f {% def
    dup dup dup
    4 mod 0 eq {(2) 4 1 roll -1 0 rmoveto} if
    4 mod 1 eq {(0) 3 1 roll -3 0 rmoveto} if
    4 mod 2 eq {(1) 2 1 roll -3 0 rmoveto} if
    4 mod 3 eq {(7 ) -5 0 rmoveto} if
} def

/i 4 def

/lineto-chars { % def
  /ex x def /ey y def
  /y exch def /x exch def
  /d x ex sub dup mul y ey sub dup mul add sqrt def
  /R y ey sub x ex sub atan def
  R rotate
  { d 0 le % ifelse
    { exit }
    { setrandcolor
      /ra rand 5 mod 3 div 10 mul 22 add def
      /Georgia-Bold findfont
      [25 0 0 ra 0 0] makefont setfont
      i f show
      /i i 1 add def
      /d d 7 sub def }
  ifelse
  } loop
  0 R sub rotate
} def

1 1 20 { % for
  /n exch def

  newpath
  0 0 moveto
  135  45 moveto
   85 140
  110 165
  110 130 curveto
  0 0 moveto
  150 130 moveto
  155 190
  210 140
  130  40 curveto
  flattenpath
  {/y exch def /x exch def}{lineto-chars}{}{} pathforall
  gsave

  32 230 moveto
  0.9 0.1 0.2 setrgbcolor
  /Georgia-Bold findfont [90 0 0 100 0 0] makefont setfont
  (2017) show

  grestore
  showpage
} for
2017 by Keiichiro Shikano on Scribd
PSの解説でよく登場する、パスに沿った文字列描画の簡易版です。 まずflattenpathしてカレントパスをlinetoの配列に変換したあと、各linetoが描く直線がX軸になるまで回転→linetoの長さまで数字を順番に書く→回転を戻す、を繰り返しています。 どのへんが簡易版かというと、グリフを書き終わったポイントは当然ながらオリジナルのパスからはずれているのだけど、そこへ戻す処理をさぼっています。そのため、ベースになるパス(ハート型)よりも文字列の描く図形のほうが肥大していく、それもフォントや処理系によってずれ幅がけっこう違ってしまう、という緩い仕様です。 このコードはWindowsのDistillerに合わせてあります。 gsだと、なぜかずれがもう一回り大きい。
過去のやつ。
2016/12/24
JSONをTeXで組版する
昨今、ドキュメント技術の主戦場といったらウェブです(ワールドワイドなほう)。 ウェブ上ではさまざまな構造化テキストが飛び交っています。 まっさきに思いつくのは、HTMLをはじめとする、ブラウザがネイティブにレンダリングできる構造化テキストでしょう。
しかしブラウザにはJavaScriptという強力なプログラミング言語の実装が組み込まれているので、HTML以外の構造化テキストをサーバから取得して整形する場合も少なくありません。 そのようなデータ形式のひとつにJSONがあります。
最近のWebサービスでは、サーバからHTMLを送らずにJSONデータだけを送り、ブラウザがそれをJavaScriptで解析して画面表示をすべて動的に作っている場合もあるようです。 この場合にブラウザがやっていることは、ある種の自動組版だといえるでしょう。 そもそもブラウザによるHTMLのレンダリング自体が自動組版だという見方もできますが、それよりさらに抽象化した、JSONを原稿とする自動組版という考え方です。 必ずしもページ全体をJSONから表示していなくても、たとえばJSONデータから表を生成してdiv要素に差し込むといった局所的な組版もありえると思います。
ブラウザとJavaScriptでできることがTeXでできないはずがない
というわけで、TeXでJSON組版をしてみました。 題材としては、CTANの各パッケージのJSONクエリとかも考えたのですが、残念ながらCTANではパッケージの詳細説明の項目にプレーンテキストではなくHTMLが直書きされている場合があるようです。 TeXで扱うのにHTMLタグは邪魔でしかありません。 まさかCTANともあろうものが、TeXでJSONデータを利用することを考えていなかったなんて。
それに、どうせならもっとクリスマスらしい題材にしたいところです。 クリスマスといえばホワイトクリスマス、ホワイトクリスマスといえば雪だるま。雪だるまを組版するなら天気予報でしょう。 OpenWeatherMapという会社のサイトで天気予報をはじめとする気象データをJSONにより取得できるので、これを組版していきましょう。
天気予報JSONデータの取得
まずはデータの取得です。TeXからHTTPリクエストを発行する汎用の手法はないので、cURLでもwgetでも好きなものを使ってください。 OpenWeatherMapでサインアップしてAPPIDを手に入れれば、たとえば下記のようなURLによって、東京の5日後までの3時間おき予報データが取得できます。
http://api.openweathermap.org/data/2.5/forecast?q=Tokyo,jp&APPID=0000000000000参考までに、取得できるのはこんな形のJSONデータです。
{"city":{
  "id":1850147,
  "name":"Tokyo",
  "coord":{"lon":139.691711,"lat":35.689499},
  "country":"JP",
  "population":0,
  "sys":{"population":0}},
 "cod":"200",
 "message":0.0103,
 "cnt":37,
 "list":[
    {"dt":1482483600,
     "main":
       {"temp":9.94,
        "temp_min":8.84,
        "temp_max":9.94,
        "pressure":1015.88,
        "sea_level":1017.11,
        "grnd_level":1015.88,
        "humidity":71,"temp_kf":1.1},
     "weather":[
       {"id":802,
        "main":"Clouds",
        "description":"scattered clouds",
        "icon":"03n"}],
     "clouds":{"all":36},
     "wind":{"speed":6.71,"deg":318.003},
     "rain":{},
     "sys":{"pod":"n"},
     "dt_txt":"2016-12-23 09:00:00"},
     ...
JSONデータのTeXによるパーズ
JSONデータを取得できたら、パーズします。JSONを読むパッケージが見当たらなかったので、ざっくり再帰下降パーザを書きました。TeXは関数型言語なので、素直に書けますね。
公開APIは以下の3つ。
- ・
\readJson #1 #2- 第一引数に渡したコントロールシーケンスに、第二引数に渡したJSONデータが格納される
- ・
\readJsonValueById #1 #2 #3- 第一引数に渡したコントロールシーケンスに、第二引数に渡したJSONデータの、第三引数の名前に対応する値が格納される
- ・
\showJsonValueById #1 #2- 第一引数に渡したJSONデータの、第二引数の名前に対応する値が入力に残る
ちょっと例を見てみましょう。青字になっているのがJSONデータです。
\documentclass{article}
\usepackage{jsonlite}

\begin{document}

\readJson{\json}{{"id":[1,2,3], "class":"foo", "data":{"id":"456"}, "info":"Is this a text?"}}
\readJsonValueById{\jsonId}{\json}{"id"}     %=> expl3 sequence
\readJsonValueById{\jsonData}{\json}{"data"} %=> id:456

\readJson{\jsonJsonData}{{\jsonData}}
\showJsonValueById{\jsonJsonData}{"id"}      %=> 456

\end{document}
天気予報JSONデータを表組する
OpenWeatherMap社から提供される天気予報JSONデータから、都市名、予報の時刻、予想天気、予想気温を取ってきて、LaTeXの表として組みましょう。
各時刻の予報は、"list"という名前の配列の各要素になっているようです。
この配列に対するmapで、表の各行を整形するという戦略にします。
実はjsonliteパッケージではJSONの配列をexpl3のシーケンスとして保持するので、シーケンス用のmapが使えます。
\NewDocumentCommand{\showForecast}{ m }{%
  \begin{longtable}{ l | c | r}
    日時 & 空模様 & 気温 \\\hline
    \endfirsthead
    日時 & 空模様 & 気温 \\\hline
    \endhead
    \seq_map_function:cN #1 \format_forecast:n
  \end{longtable}
}
TeX言語のくせにシーケンスとかmapとか、お前はなにを言ってるのだ、という感じかもしれませんが、2016年にもなればそういうものなんです。 そもそもTeXは関数型言語なのだからシーケンスに対するmapくらいできないはずがありません。
あとは、\format_forecast:nを書いていくだけなんですが、
OpenWeatherMap社のデータで"weather"がさらに配列になっていたりして無駄にめんどくさいので解説は省略します。
jsonliteパッケージと同じディレクトリに完全なコードを置いてあるので参考にしてください。
天気記号のサポート数がそこそこあるDejaVuSansを使いたかったので、XeLaTeXで実行してみた結果がこれです。DejaVuSansの☃はどことなく品がいいですね。


ところで、Brzozie(ブジョジェ)という地名がどこなのか気になった人がいるかもしれません。ブジョジェはポーランドの湖水地方で、バホテク湖があるところです。来年のTUG2017は、このバホテク湖で毎年開催されているBachoTeXというイベントと合同で5月に開催されることになっています。なんとか参加するぞ。
そしてこの記事は、第五回となるTeX&LaTeXアドベントカレンダーの24日めの記事です。 昨日はアセトアミノフェンさん(この記事を見てDejaVuSansを使うことを思いつきました)、明日の最終日はZRさんです。
2016/12/03
独立系出版社をやるという覚悟について
カナダ最大の都市であるトロントから北に向かって1時間ちょっと、荒野だか畑だか牧場だかよくわからない広大な土地を走り抜けたところに、エリンという小さな村があります。 19世紀に開拓された当時からメインストリートであったと思われる道が、川の蛇行している部分を堰き止めるように貫いていて、その両脇だけで主な商圏が形成されているような素朴な村です。
そんな小さな村に、なんと出版社があります。 その名もThe Porcupine’s Quill。 直訳すると「ヤマアラシの針」ですね。 言うまでもなく独立系の出版社で、大手からは陽の目を見るのが難しいカナダ発の文学者やアーティストの作品を手掛けているようです。
今年の7月、この《ヤマアラシの針出版》を訪問する機会がありました。 世界中のTeX関係者が集まるTUGという会合があるんですが、2016年の開催地がトロントで、その一環として《ヤマアラシの針出版》の見学会が組まれていたのです。 トロントからエリン村まで農道(もしくは牧道)を延々とかっ飛ばし、パン屋さんの前でマイクロバスを降りると、その何軒か隣の靴屋みたいな建物が《ヤマアラシの針出版》の本社でした。
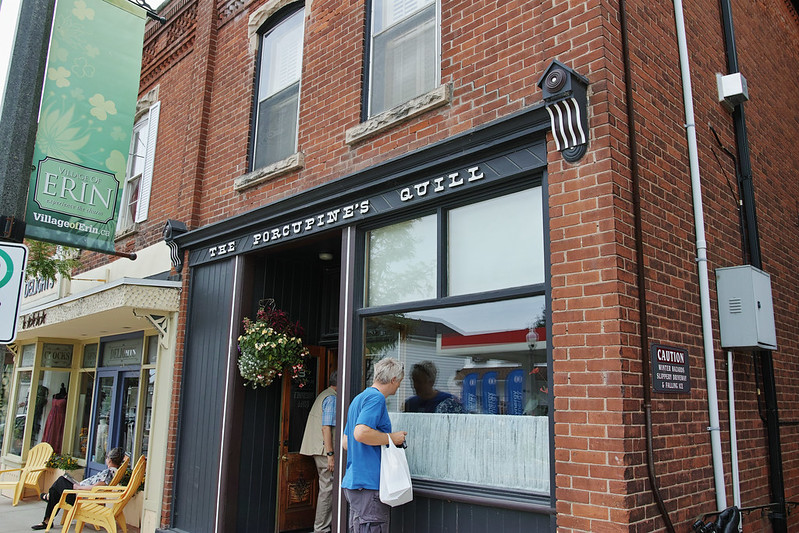
こんなカナダのど田舎に本社を構えているというだけで十分に話として面白いんですが、この出版社、他の多くの出版社と違って、印刷から製本まで本づくりのすべてを自前でやっています。 それも、ドイツ製のオフセット印刷機やら製本機やらを社内に一式すべて用意し、経営者であるティムさんと奥さんのエルクさんが手作業で本を作っているのです。 ちなみに、やや出来過ぎ感がありますが、お二人の姓は「インクスター」さんといいます。
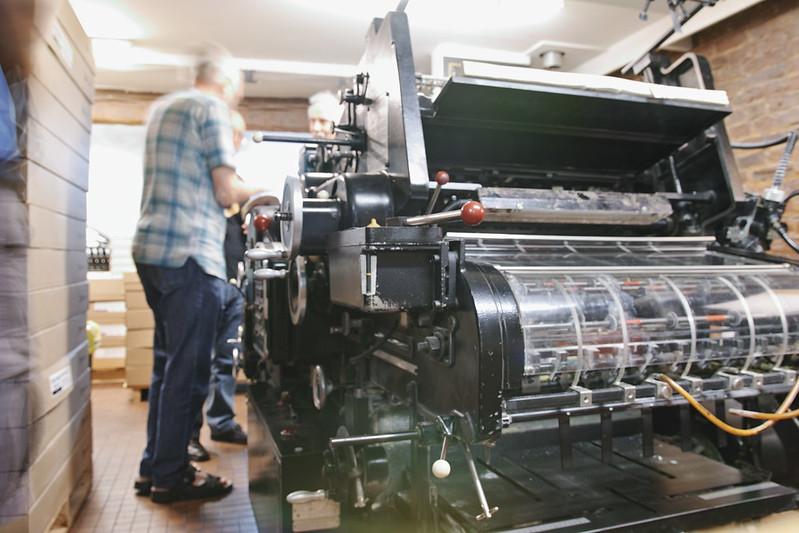
これが、さっきの建物の地下にあるHeidelberg Kordというオフセット印刷機。とてもよく手入れされていて、油でてかてかしています。インクが香ばしい。
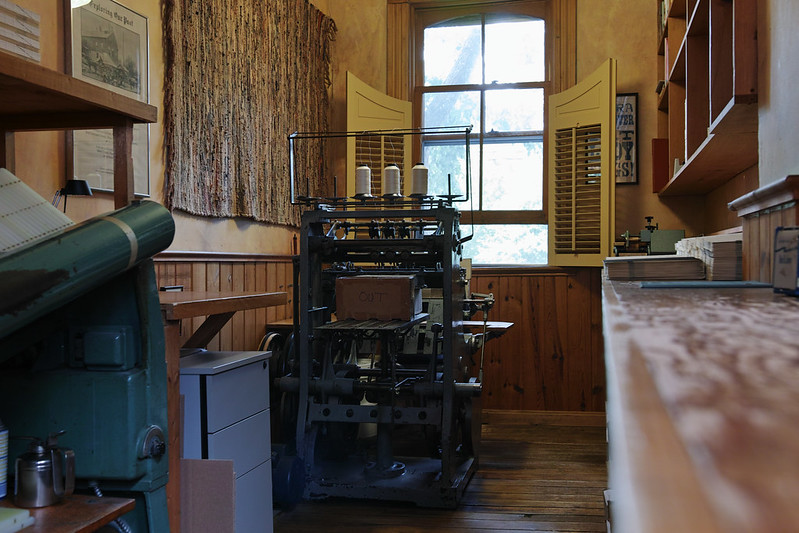
こちらは建物の1階に実装されている、本をかがるための機械。ファンシーな窓の鎧戸と陽光のせいで博物館の展示物っぽいけど、むちゃくちゃ軽快に稼働します。
正直なところ、訪問前にはそれほど大きな期待はしていませんでした。 自分とは畑違いの文芸系の出版社っぽいし、そもそも出版社の仕事なんてどこも大差ありません。
しかし実際に《ヤマアラシの針出版》でティムさんから「どういう考えで本を企画し、作り、それを売ってきたか」を語ってもらい、ビンテージな機械が力学を駆使して本を作り上げるようすを目の当たりにすると、いちいち唸りっぱなしでした。 出版社っていうのは、こんなふうに本を作って売るっていう仕事であり、その骨格がまさにいま自分の目の前に展開されてるんだなと。
- 出版社の仕事なんて、確かにどこも大差ないけれど、誠実にやっていくと結局は「モノづくり」になるんだよなという気持ち。
- 電子書籍もいいけど、モノとしての物理は単純に強いなという気持ち。
- 年間ノルマで本の形を整えなくても、こんなふうに、やりたい人がやりたいように出版をやれるのが健全だよなという気持ち。
- ぼくも、完全に同じやり方ではないかもだけど、こんなふうにして本にかかわっていくぞという気持ち。
なにをかくそう、ぼくも自分で出版をやりたいと思って、昨年2015年の12月1日にラムダノート株式会社という会社を作りました。 今年2016年の7月にThe Porcupine’s Quillを訪問して、自分が仕事としてやりたいことは「本を作って買ってもらうこと」なんだなと再確認しました。 来年2017年の2月ころには、最初のタイトルとして、TLSの関連書を発行する予定です。 年が明けてしばらくしたら直販サイトで予約できるようにする予定(予定)なので、ご期待ください。
そういえば、この最初のタイトルは翻訳ものなんですが、原書を発行しているロンドンの出版社もやっぱり独立系出版社でした。 そっちもそっちで4月に訪問してたくさん刺激を受けたので、翻訳発行後にあらためてどこかで話ができればいいなと思います。
なお、この記事はラムダノート株式会社の設立にあたって出資して頂いた株式会社時雨堂の社長になんか書けといわれ、pyspaアドベントカレンダー2016のエントリーとして書きました。pyspaには脱サラする直前からずっと癒されてきました。でも、昨日はイアンさん、明日はモリヨシさんだし、あきらかに場違いな記事だろこれ。
2016/07/01
主観でプログラミング言語5種類をあっさり解説
現在プログラミング言語は200種類存在していると言われてるようですが、これはたぶんLisp族の言語だけを数えた値です。
あるプログラミング言語(汎用のもの)がどんな用途に適しているかは、人によって大きく意見が分かれるので、用途を絞ったからといって適したプログラミング言語が決められるわけではありません。そもそも今日の世界における用途が明日の世界にも存在するとは限らないし。
この記事では、ぼくがHello Worldくらいは書いたことがある言語5種類をあっさりと解説しようと思ったけど、そんな知識もないので、「プログラミングしてみたい人向け、言語に関する5つのアドバイス」です。学習しない言語の選択に役立ててください。
Go
それなりに具体的で明確な「Cを使う」理由があるのでない限り、Cで学べるようなプログラミングはGoで学んだほうがいいと思います。
HaskellかOCaml
これといった目的もなくプログラミングを始めたいなら、静的型付き言語で始めるほうがいろいろ実りがあると思います。異論は認めるけど。 HaskellやOCamlであれば、現代的なアプリケーションを試しに作ってみるのに必要なライブラリもそれなりに充実しています。
Scheme
Schemeがいいのは、コンピュータがなくてもプログラミングを学べる点です。Schemeの実装は黒板だと言われるくらいです。
正規表現
特定のアプリを意識した言語でプログラミングし始めるよりも、正規表現をひととおり自在に使えるほうが、最初のうちは役立つ場面が多いと思います。 Rubyとかも、最初は正規表現全開な感じでテキストフィルタを書いてみるのがいいと思います。
先生や友だちや同僚がよく知っている言語
というわけで、ぼくの近くにいる人はTeXから学ぶことになります。
2016/06/20
特殊エンジニア向け数学ガイドツアー本『グッド・マス』の話
6月25日、つまり今週末、『グッド・マス ギークのための数・論理・計算機科学』という本が発売されます。 話せば長い事情があって、発売前だけど訳者の次くらいに書籍の内容を熟知しているので、私的な紹介を書いてみました。
計算機のプロが書いた現代数学ガイドツアー
世に数学系の読み物はたくさん出版されています。純粋数学のプロが書いたものもあれば、そうでない人が書いたものもあります。 『グッド・マス』は、後者です。著者のマークさんは計算機科学のプロであり、数学のプロではありません。そのため、本書でいう「数学」も、コンピュータエンジニア的な目線で描かれます。 たとえば、連分数の話をするときはScalaで実装し始めるし、論理学の話をすれば「Prologはいいぞ」って始まるし、計算といったらチューリングマシンとBrainfuckでありλ計算です。 本書を一言で表すと、「コンピュータエンジニア、とくにプログラミング言語とか大好きっ子にとって興味深いであろう観光名所をめぐる現代数学ガイドツアー」です。 日常の言葉で抽象数学を分かりやすく伝える系の読み物を期待して読み始めると、肩透かしを食うと思います。
ちなみにですが、そういう方向で数学ネタを気軽に味わいたいとしたら、いまなら"Cakes, Custard and Category Theory"という本が面白いと思います。 『ケーキ、カスタード、それに圏論』というタイトルどおり、後半はまるまる圏論の何がおいしいのかを説明するのに割かれています。こないだ翻訳も出たようです(邦題には「圏論」ってないけど)。
この"Cakes, Custard and Category Theory"という本の著者であるEugenia Chengは、生粋のプロ数学者ですが、ユーチューバ―として有名だったりもします。
ナイフを振り回しながら教壇に立つチェン先生かわゆす。
『グッド・マス』の話だった
閑話休題。『グッド・マス』のゴールは、日常の言葉で抽象数学を語ることではなく、コンピュータ好きなら知っていて損のない数学ネタを一通りさらうことです。 とくに重視されてるのは、公理的に、論理を使って、構成的に数学という体系を捉える方法を伝えることです。 著者のマークさんは、冒頭の第1章から、数学の対象を日常的な感覚だけで語らないよう読者に促します。 エンジニアになじみのある日常的な感覚にも頼りつつ、数とか集合、証明といった対象を、現代数学というルールで捉えるやり方を正面から見せてくれる感じです。 数学の教科書とは違う方法で、コンピュータ好きな人が「生の数学」を味見する本だといえるでしょう。 これが本書の貴重なところだと思います。
もともと単発の記事をまとめた本ということもあって、あからさまなストーリーもなく、面白そうな部分だけをつまみ読みできます。「数って何?」みたいな前半の軽めの話題だけ読んでもいいし、Prologを使って一階の述語論理を学ぶ第4部だけ眺めてもいいし、公理的な集合論のノリをさらってみるだけでもいいでしょう。 特に最後の第6部は、正規表現とか再帰、λ計算、型といったプログラミング言語好き向けの話題で占められているので、この辺だけ読むのもお勧めです。 とはいえ後半は「数学をやってる現代人が暗に共有している意識を部外者が垣間見る」ことができるような構成になっているので、論理を扱っている第4部くらいからは順番に読むことをお勧めします。 自分は、はじめて原書を通しで読んだとき、第1章の自然数の説明でのっけからペアノの公理を持ち出してきたのも後半のためのネタ振りだったのかーと納得しました。
一方、『グッド・マス』にはあまり登場しない数学の話もたくさんあります。 解析とか位相に関するネタは本書にはまったく出てきません(ε-δのわかりやすい解説はないし、ドーナツとマグカップがどうこうみたいな話もない)。圏論もないです(Haskellのコードは出てきますが、正規表現の微分を実装するのに使われます)。 このへんの話題については期待しないでください。
あと、いわゆる一般人向け数学の本で必ず引き合いに出される黄金比については完全にコケにされているので、そういうのが好きな人は注意してください。 目次を見ると黄金比を扱っている章がありますが、これはマークさんが「おれは黄金比をもてはやす連中が嫌いだ」ということを表明するためにある章です。黄金比ネタが好きな人にはこの本はお勧めできません。
もうひとつ触れておきたいのは、なるべく読み手が飽きないようにしたいと思うあまりにマークさんの筆がちょくちょく滑るという点です。 ところどころ自由すぎる解釈で書き進めてしまった内容を、コンピュータ系技術書版元であるPragProgsには編集しきることができなかったのか、原書には突っ込みどころのある箇所や単純なミスがけっこう残っています。 ただし、そんな暴走気味の部分はcocoatomoが訳注などでしっかり引き締めてくれているし、 翻訳版のレビューをしてくれた方々(計算機と数学の両方に足をかけてるプロばかり)にも細かい部分まで目を通してもらえてるので、 原文の微妙な勘違いはかなり補正されていました。 翻訳版は、私が企画時にぼんやり思い描いていた以上に、かなり安心して楽しめる内容に仕上がっていると思います。
というわけで6月25日発売の『グッド・マス ギークのための数・論理・計算機科学』、コンピュータをふだんから使っていて、もうちょっと数学的な考え方を知りたいよという人には、とっかかりとしてお勧めです。
個人的なあとがき
本書のもとになっているのは、主に「数学」に関連したネタを扱う英語圏では有名な古参のブログ "Good Math / Bad Math" です。 "Good Math / Bad Math"は、いまほどインターネット上に一般向け数学ネタが溢れていなかったころから勢いのある筆致で数学系の記事を量産してきたブログで、 幾度かの移転を経て現在でもわりと活発に更新が続いています。
"Good Math / Bad Math"
http://www.goodmath.org
過去には『マンガでわかる統計学』の英語版に対する肯定的なレビューがアップされたことなんかもありました。 『マンガでわかる統計学』は英語版もかなりよく売れたんですが、その認知度はこのブログにおける紹介記事で一気にあがった感があります。 (ただしシリーズ全体の認知度として見ると、Boing Boingで『マンガでわかるデータベース』がネタ的に扱われたことのほうが大きい)
"BOOK REVIEW: THE MANGA GUIDE TO STATISTICS"
http://www.goodmath.org/blog/2008/12/13/book-review-the-manga-guide-to-statistics/
自分はたまたま『マンガでわかる統計学』の英語版に少し関与していたこともあって、 それからしばらく"Good Math / Bad Math"の記事をちょくちょくチェックしていました。 そんなある日、「このブログをもとにして本を出すよ」という記事が掲載されます。 しかも出版社はPragmatic Bookshelf社とのこと。 Pragmatic Bookshelf社といえば、『RailsによるアジャイルWebプログラミング』とか『プログラミングErlang』とか『情熱プログラマー』といったIT系書籍で有名な版元です。 これは面白い本になるに違いないと思いながら、続報を待つこと4年、ようやく2013年にベータ版の書籍が発売開始になったのでした。
さっそくβ版を自分で買ってKindleに突っ込み、一通り目を通してみて、「間違いなくそのうちどこかで日本語版が出るだろうな」と確信しました。 と同時に、あちこちマークアップの変換結果がコケていたりして、商品としての出来には微妙なところも感じていました。Pragmatic Bookshelf社では独自形式のXML原稿から紙の書籍と電子書籍を生成しているんですが、 それなりに数式が多く含まれる本書の原稿に対し、その変換処理の調整がいまいちうまくいっていないのは明白でした。
「どうせ日本語版が出るなら訳本には自分自身が関与したい、いやむしろ、自分が関与せずに日本語版が作られたら書籍として残念な出来になってしまいかねないぞ」 というわけのわからない使命感に駆られ、当時所属していた出版社で版権を抑えたうえで翻訳に興味がある有識者がいないかなーと思ってこんなツイートをしてみたのでした。
というわけで、あの伝説の数学ブロガーMARKCCによるプログラマ向け数学入門の "Good Math" を翻訳したいわけですが
— keiichiro shikano λ♪ (@golden_lucky) 2014年4月23日
このツイートに見事に引っかかってくれたのが、そのちょっと前に「スタート代数」という勉強会を主催していたcocoatomoさんでした。 自分もスタート代数に何回か参加していたことから、お互いに何となく面識があったこともあって、企画を通して翻訳を進めてもらうまでは実に順調に話が進みました。 原著の原稿データから日本語版のPDFを自動生成する環境はこちらで用意し、cocoatomoさんにも翻訳をこまめにgit pushしてもらっていたので、 あとは日本語版が少しずつ形になっていくのを時々眺めていればいいという、(個人的には)きわめて理想的な感じで制作が進んでいきました。
ところが、翻訳がずいぶん進んで編集もぼちぼち開始し、これからいよいよ制作も本格化しようという段階になって、自分自身が会社を辞めるしかないという不測の事態になってしまいました。 発行までの実務は会社に残った同僚に引き継げることになったし、cocoatomoさんの好意でその後も翻訳制作の作業にリモートで口を出し続けることはできたのですが、直接の担当者として最後まで携われないまま辞めるというのは正直つらい選択でした(念のため補足しておくと、もっとつらいことがあったので辞めた)。
その翻訳版が、ついに6月25日に発行されることになりました。感無量です。 数式を含むマークアップの変換についても、仕込んでおいたCI上での作業プロセスを外注で回してもらえたので、書籍として申し分ない感じに仕上がっていると思います。いまの僕には、この本がものすごく売れても特に利益的なものはないのだけど(アマゾンアソシエイトについてはよろしくお願いします)、手に取ってもらう人が増えればとてもうれしいです。
2016/06/08
Markdown原稿をGitHubで管理して本にする仕組みが出版社で導入されないわけ
これ、FAQっぽいんで、ちょっと私見を書いておこうと思います。
とくに技術書に関しては、Markdownで原稿を書きたいとか、修正はPull Requestでもらえると楽とか、そういう便利な世界を知っている人たちが執筆者なので、 「MS Wordで書いてもらった原稿を、こちらでDTPの担当者に組版してもらいます。修正は紙に赤字か、PDFをメールで送るので、そこにコメントを入れてください」という古き良き時代の出版社のやり方を目にすると、 「出版社って遅れてるよなー」という感想を抱かれることが多いのだと思います。 その結果、「自分たちはITのプロとして出版のためのプラットフォームを作れるだろうから、それを使ってもらえないものか」という方向の考え方に至るのはよくわかります。
しかし、これには、二つの面から「ちょっと認識が違うから待って」と言いたい。
まず「認識が違う」と思うのは、プレインオールドでない方法も部分的にはすでにけっこう導入されているという事実です。 とくに自分は、全面的に「マークアップ原稿を最後の最後までGitHubで管理する」ための仕組みをもう何年も実際に運用して売り物の本を作ってきました。 なので、「出版の中の人は現代的なプラットフォームを使えない」と言われると、どうしても「ぼくはちがうもん」と言いたくなるんですが、なんで自分はできてるのか、という点についてはあとで改めて書きます。
もう一つ、「出版のための現代的なプラットフォームが必要」という話に対して「うーん」って感じてしまうのは、 ルールが決まってる組版で自由な表現をするための仕組みはどうするの?という点に対する回答がないことです。 これは、原稿の形式と版管理ではどうにもならない問題です。
実際にそういうプラットフォームで売り物の本を制作してきた経験からすると、毎回いちばん頭を悩ませるのは、 プラットフォームをチューニングして、「今回のプロジェクトで作りたい形の本を作れるようにする」部分です。 毎回同じ体裁で似たような本を作るなら、yamlなどの設定を書き換えることによるシステム的なチューニングだけで済むかもしれません。というか、実際に済んでいます。 それでも、そのチューニングができる人が出版社の中に必要になるんですが、その程度なら、まあ、システムのお守りをする人がプロジェクトごとに担当者に要件を聞いて調整すればいいでしょう。 頭が痛いのは、「この本では見出しでこんな表現をしたい」とか、「強調をいくつか使い分けたい」とか、「標準的ではない構成にしたい」とか、そういう個別の本の中身に対する要求に合わせたチューニングです。
そういう要求を吸収できるようにシステムを作りたいということであれば、Markdownの原稿では絶対に無理(無理)なので、素直にLaTeXでもなんでも既存のプラットフォームを使おうよ。。(本音)
勝手が許されない「組版」と、自由な「レイアウト」と、それを吸収するプラットフォーム
出版物は、特に紙の本は、歴史がそれなりにあるので細部のルール(いわゆる組版)がわりときっちりしてます。 そのルールを逸脱していると、単純に読みにくい本になります。 このへん、ブラウザのレンダリングに任せればいいという発想でWebページを作るのとは違っているので、 たとえソースがXMLベースの原稿でも、本気のページ組版のためには、通常のブラウザエンジンではなく専用のフォーマッターが使われています。 もしブラウザのレンダリングエンジンでJavaScriptとCSSを使ってきちんと組版しようと思ったら、専門の会社を一つ作らないといけないレベルで大仕事です。
そんなわけで、出版物というのは、組版というミクロな部分の見た目についてはあまり融通が利きません。 誰でも使えるInDesignというアプリケーションがあるのにDTPがプロの仕事として成立してるのは、 一昔前の業種がいつまでも生き残ってるのでも、デザインセンスが必要だからだけでもなく、組版という仕事が本質的に専門知識を要求されるものだからです。
そうはいっても自動組版したい人、軽量マークアップの原稿を機械的に組版したい人にとっての選択肢は、いまは主にバックグラウンドでLaTeXを使うプラットフォームになると思います。 で、そのLaTeXですが、ご存じのとおり鬼門ですよね。 もっとも、Markdown+PandocやSphinx、Re:VIEWでとりあえずページ組版されたものを出すなら既成のスタイルを使うだけなので、とくに苦労はいりません。
問題は、ちょっと違った見た目にしたり、新しいレイアウト要素を追加したかったりする場合です。 これにはLaTeXのコマンドを使って自分でスタイルを書くしかありません。 しかも、新しいレイアウト要素を追加するにはそれだけでは済まず、ソースにおける構造とレイアウトとのマッピングを定義する必要があります。 自分は、このような拡張が簡単にできないと死ぬと思ったので、かなり早い段階でそのためのDSLを開発してました。 これまで十年くらい、「マークアップしたテキスト原稿を版管理」しながら「本として最後まで作り込む」という環境を実現できてたのは、こういう仕組みを作ったからです。
なお、これは自分だけでなく、「マークアップしたテキスト原稿を版管理」しながら「成果物として最後まで作り込む」を実現している人は、だいたいこのような構造とレイアウトのマッピングをする仕組みを自分たちで作り上げてるようです、というのを昔開催した「版管理+自動組版」という勉強会で知りました。
厄介なのは、そういう仕組みを「誰もが使える」ようにする点です。 GitHubのようなベースとなるプラットフォームを使い始めてもらうためのハードルが高いわけではありません。 自分の経験だと、毎回の書籍原稿における文書の構造とレイアウトを実現するメカニズムの両方をそれなりに理解しないといけないのが唯一の障壁です。 そういうことを考えたい人が中に常駐していないと、プラットフォームがあったところで、多様な個々の本に対してそれを適用し続けることができないのです。
むしろ問われてるのは出版ビジネスの考え方かも
というわけで自分は、軽量マークアップのテキスト原稿をGitで管理して本にするという簡単な仕組みが出版社の中に普及しないのは、 そういうプラットフォームを使って勝手が許されない組版かつ自由なレイアウトを実現しながら本を作り込もうとする人が足りてないことが大きな理由だと思っています。
もっとも、これは「出版する本は作りこむべきだ」という個人的な思いによる分析なので、 単純なプラットフォームで実現できる形の本だけで出版というビジネスを回してやろう、という大胆な発想もありえると思います。 そういう発想を追求したい場合は、米O'reillyのAtlas+Safariのような仕組みや、Pragmatic Bookshelf社の取り組みについて調べてみるとよいと思います。