2013/12/18

colortbl で \cline を使いたい

日本でLaTeXが生きのこるには、縦横無尽に罫線が引かれた彩り豊かな表を描けなければならない。 でも、表のセルに色を塗るための colortbl パッケージと、横線を好きな場所に引くための標準的な方法である \cline には、罫線までもが色で塗りつぶされてしまうという困った問題があります。

\begin{tabular}
  {|>{\color{white}\columncolor{red}  }c
   |>{\color{white}\columncolor{green}}c
   |>{\color{white}\columncolor{blue} }c|} \hline
  a & b & c \\ \cline{1-1}\cline{3-3}
  1 &   & 3 \\ \hline
\end{tabular}

本当なら、こんな具合に、左右の列だけにセル間の横罫線が引かれてほしいわけです。

これは TeX & LaTeX Advent Calendar の18日目の記事です。 昨日はabenoriさんの「可換図式を書こう:tikz-cdを使う.」です。

公式見解

この \cline が上書きされてしまう現象は、 colortbl のマニュアルでも言及されている既知の問題です。 いわく、「これは \cline の仕様なので代わりに \hhline を使え」とあります。

10 Less fun with \cline
Lines produced by \cline are coloured if you use \arrayrulecolor but you may not notice as they are covered up by any colour pannels in the following row. This is a `feature' of \cline. If using this package you would probably better using the - rule type in a \hhline argument, rather than \cline.

実際、"TeX - LaTeX Stack Exchange" における質問でも、 \hhline を使った回答が寄せられているようです(参照1、参照2)。 しかしぶっちゃけ \hhline はまったく解決策になりません。 それどころか、今度は罫線を引きたくない箇所に白い線が出現したり、縦罫線が切断されたりしてしまいます。

\usepackage{hhline}
...
\begin{tabular}
  {|>{\color{white}\columncolor{red}  }c
   |>{\color{white}\columncolor{green}}c
   |>{\color{white}\columncolor{blue} }c|} \hline
  a & b & c \\ \hhline{-|~|-}
  1 &   & 3 \\ \hline
\end{tabular}

これはひどい。

ごまかし方

colortbl で特定の列にだけ横罫線を引くことは不可能なのでしょうか。 実は、方法がないではないので、それを紹介します。ただし後述するように、厳密にいうとこの解法には落とし穴があるので注意してください。

そもそもなんで罫線が塗りつぶされるかというと、 colortbl では罫線を引くプロセスのあとにセルに色を塗っているからなのですが、これは TeX の仕組み的にはチートできません。 色を塗るにはセルの大きさが決定していなければならず、その段階では罫線も引き終わることになっているからです。

でも逆に考えれば、セルの高さに対して罫線の位置をはじめからずらして引くようにしてしまえば、罫線を微妙に避けて色を塗ってくれるはずです。 そこで次のような \cline の定義(もとは latex.ltx にあるけど colortbl パッケージで上書きされてるもの)を……

%% \@cine from colortbl.sty
\def\@cline#1-#2\@nil{%
  \omit
  \@multicnt#1%
  \advance\@multispan\m@ne
  \ifnum\@multicnt=\@ne\@firstofone{&\omit}\fi
  \@multicnt#2%
  \advance\@multicnt-#1%
  \advance\@multispan\@ne
  {\CT@arc@\leaders\hrule\@height\arrayrulewidth\hfill}%
  \cr
  \noalign{\vskip-\arrayrulewidth}}

次のように書き換えてプリアンブルに書きます(\makeatletter を忘れずに)。

\def\@cline#1-#2\@nil{%
  \noalign{\vskip-\arrayrulewidth}
  \omit
  \@multicnt#1%
  \advance\@multispan\m@ne
  \ifnum\@multicnt=\@ne\@firstofone{&\omit}\fi
  \@multicnt#2%
  \advance\@multicnt-#1%
  \advance\@multispan\@ne
  {\CT@arc@\leaders\hrule\@height\arrayrulewidth\hfill}%
  \cr}

元の定義で一番最後にあった \noalign{\vskip-\arrayrulewidth} を先頭にもってきただけで、ほかはそのままです。 これだけで、ふつうに \cline を使えば横罫線が出現するようになります。もちろん不要な箇所に白線が出ることもありません。

\begin{tabular}
  {|>{\color{white}\columncolor{red}  }c
   |>{\color{white}\columncolor{green}}c
   |>{\color{white}\columncolor{blue} }c|} \hline
  a & b & c \\ \cline{1-1}\cline{3-3}
  1 &   & 3 \\ \hline
\end{tabular}

やったね。

うまくないところ

この方法は、罫線を、罫線の幅だけ上にちょっとずらすことで、一見成功しているように見える結果を得ています。 なので、ずれてない本来の位置に罫線を一緒に引いてみると、アラがわかります。

\begin{tabular}
  {|>{\color{white}\columncolor{red}  }c
   |>{\color{white}\columncolor{green}}c
   |>{\color{white}\columncolor{blue} }c|} \hline
  a & b & c \\ \cline{1-1}\cline{3-3}\hilne
  1 &   & 3 \\ \hline
\end{tabular}

残念ですね。

2013/12/10

XML を変換するなら Haskell(HXT) で

思えば自分にとってプログラミングとは、XML っぽいドキュメントを操作することでした。 XML パーザを書いてみたり、SXML でいろいろがんばったり、やる前から XSLT に挫折したり。 とにかく気持ちよく XML を操作する方法をこれまでいろいろ探してきたわけですが、今はこう断言できます。 XML をいじるのに最高な道具は HXT(Haskell XML Toolbox)であると。 そこで自分用のメモを兼ねて、「こんなふうに HXT を使ってます」を紹介しようと思います。 基本的な Haskell 力が高くないので、「理解を間違っている」とか「もっとこう使うべき」というツッコミ歓迎です。

HXT がうれしい理由

XML のような木構造のデータをいじろうと思ったとき、まず思いつくのは、根っこから順番に要素をたどりつつ処理していく方法です。 しかし、この方法は案外と融通が利きません。 常に部分木だけを見ればいい仕事なら気楽なのですが、親の要素に戻ったり、兄弟要素にアクセスしたりする必要があるときは、 「いま木全体のどこを処理してるか」という情報を持ち歩くしかないからです。 そして、「いま木全体のどこを処理してるか」を意識しながらコードを書くには、かなりの精神力が要求されます。

HXT では、これとはちょっと違う方法で XML の木構造をいじれます。 「木のこの部分を何かに変換」とか「木のここを取り出す」とか、そういう個別の処理を組み合わせることで全体の変換処理を書けるのです。 同様のアプローチをとるツールとしては XSLT がよく知られていますが、 HXT では各処理を「ふつうのプログラミング言語」である Haskell のコードとして書けるので、 はるかに柔軟だといえると思っています(なにせ XSLT に挫折しているので断言するほどの自信はない)。

組み合わせたい各処理は、「XML の木」から「XML の木」への関数だと思えます。それらをいろいろ組み合わせたいのだから、これは「XML の木構造、および、XML木→XML木な関数たち」から「XMLの木構造、および、XML木→XML木な関数たち」への対応だと思えます。というわけで、 HXT では変換処理を Haskell における圏の間の関手 >>> を使ってつなげたりできます。

とはいえ、 >>> だけだと条件分岐もできないし、大して面白い組み合わせが書けないので、 HXT ではもうちょっと広い概念である「アロー」を使って XML 木の変換を組み合わせられるようになっています。アローについて詳しくは『関数プログラミングの楽しみ』の第10章を読んでください(言うまでもなくこれは宣伝です)。

変換を組み合わせる前に

まずは変換処理が一つしかない場合から書いてみます。 <div class="chapter">...<div> という要素を <h1>...</h1> に包み直すという、単純な変換がやりたいとしましょう。 構造を変えるのではなく、属性に応じて要素名を書き換えるだけの処理です。

なにはともあれ、最初に HXT まわりのモジュールを読み込みます。

import Text.XML.HXT.Core
import Text.XML.HXT.Arrow.XmlArrow
import Control.Arrow

これから変換処理をアローとして書いていくわけですが、外界とのやり取りにもアローを使います。 ここでは、ファイルなどの URI を受け取って入力を行うアロー readDocument と、同じく出力を行うアロー writeDocument を使います。 それぞれ入出力の書式などを指定することもできて、 DTD の指定やインデントの有無を設定できるのですが、細かいことはドキュメントを参照してください。 さらに、 main の中でアローを実行するために、 runX という関数を使います。

readDocument、 writeDocument、 それにこれから書く予定の「div を h1 に変換する」アローである chapterToH1 という三つのアローをすべて >>> でつないで一つのアローを作り、 それを runX で実行するだけの超単純な main は、こんな感じになります。

main :: IO ()
main = do
  runX (readDocument [] "test.html"
        >>>
        chapterToH1
        >>>
        writeDocument [] "result.html"
        )
  return ()

それでは、肝心の変換処理 chapterToH1 を書いてみましょう。やりたいことは、「もし div が class 属性に chapter を持っていたら要素名を h1 にして、 class 属性はいらないので消してしまう」です。これはそのまま、 XmlTree から XmlTree へのアロー ArrowXml として、こんな Haskell の関数で書けます。

chapterToH1 :: (ArrowXml a) => a XmlTree XmlTree
chapterToH1 =
    processBottomUp
    (ifA (hasName "div" >>> hasAttrValue "class" (=="chapter"))
             ((setElemName $ mkName "h1") >>> removeAttr "class")
             (this))

狙いの div がどこに出てくるかわからないので、 processBottomUp を使って木を再帰的に見るようにしています。 ifA は条件分岐のためのアローです。条件にマッチしない要素はそのまま残しておきたいので、 else に相当する部分では this アローを設定しています(もしマッチする要素だけ残したいなら none というアローを使います)。そのほかのアローの役割は関数名でわかりますね。こんな具合にアローをつなげて、目的の処理を表すアローを書くわけです。

Haskellのパワーを活用する

先ほどの例と同じ要領で「div 要素を class 属性に基づいて都合のいい名前の要素に変換する」アローをコピペで量産し、それら全部を >>> でつなげるだけでも、それなりに役に立つXML変換プログラムが書けそうですが、それはつらいので、できればアローを作る関数を一つだけ作って、それを使って作ったアローたちを >>> で fold できないものかなと考えますよねふつう。実際、アロー版のfoldといえる seqA が用意されているので、こんなふうに書けます。

(seqA . map (uncurry divClassToElem)
           $ [("chapter", "h1")
             ,("section", "h2")
             ,("para", "p")
             ])

これを runX の中に書けばいいわけです。 divClassToElem はこんなふうに定義すればいいでしょう。

divClassToElem :: (ArrowXml a) =>
                  String            -- if DIV is this class,
               -> String            -- turn that into this element.
               -> a XmlTree XmlTree
divClassToElem cls elm =
    processTopDown
    (ifA (hasName "div" >>> isClass cls)
             (tameClass elm)
             (this))

tameClass :: (ArrowXml a) => String -> a XmlTree XmlTree
tameClass elm = (setElemName $ mkName elm) >>>
                removeAttr "class"

isClass :: (ArrowXml a) => String -> a XmlTree XmlTree
isClass val = hasAttrValue "class" (==val)

兄弟をまとめる

もうちょっと現実的な例題として、いかにも組版ソフトが吐き出したっぽい HTML を、それなりに整った HTML に変換したいとします。つまり、こんなデータを……

<html>
<head></head>
<body>
<div class="chapter">XSLTを捨ててHXTを使おう</div>
<div class="para">HXTでXSLTの処理系さえ実装できる!</div>
<div class="section">Allowとは</div>
<div class="para">こまけーこたーどーでもいいんだよ。</div>
<div class="section">HXTの使い方</div>
<div class="bulletA"><span class="shell">cabal install hxt</span></div>
<div class="bulletB"><span class="haskell">import Text.XML.HXT.Core</span></div>
<div class="bulletB"><span class="haskell">let doc = readString [] text</span></div>
<div class="bulletC"><span class="haskell">runX doc</span></div>
</body>
</html>

こんなふうに変換したいとします。

<html>
  <head/>
  <body>
  <h1>XSLTを捨ててHXTを使おう</h1>
  <p>HXTでXSLTの処理系さえ実装できる!</p>
  <h2>Allowとは</h2>
  <p>こまけーこたーどーでもいいんだよ。</p>
  <h2>HXTの使い方</h2>
  <ul>
    <li>
      <code>cabal install hxt</code>
    </li>
    <li>
      <code>import Text.XML.HXT.Core</code>
    </li>
    <li>
      <code>let doc = readString [] text</code>
    </li>
    <li>
      <code>runX doc</code>
    </li>
  </ul>
  </body>
</html>

この例で面倒なのは、 class 属性の値だけに基づいて、元の XML で潰れてしまっている構造(この場合は ul 要素)を取り出さなければならないところです。 面倒とはいっても、リストみたいなデータ構造から「bulletA」~「bulletなんとか」までの連続する要素をとってくるような問題そのものは、Haskell であれば Data.List の groupBy を使って割と単純に解けてしまいます。 特定の属性の値という条件のままで考えるとちょっと込み入ってしまうので、代わりに要素名がそれぞれ「bulletなんとか」になってると単純化して考えてみます。 HXT なら、要素名を属性の値に変換した木を作るアローを作って前段にかませばいいだけなので、こうみなしても後で困ることはありません。

import qualified Text.XML.HXT.DOM.XmlNode as XN
import Data.List

groupBullet :: [XmlTree] -> [XmlTree]
groupBullet ts = map bulletlines $ groupBy isBullet ts
  where bulletlines [x] = x
        bulletlines a@(x:xs) = XN.mkElement (mkName "ul") [] a

isBullet :: XmlTree -> XmlTree -> Bool
isBullet t1 t2 = case (XN.getElemName t1, XN.getElemName t2) of
  (Just x', Just y') -> let x = qualifiedName x'
                            y = qualifiedName y'
                        in    (isPrefixOf "bullet" x)
                           && (isPrefixOf "bullet" y)
                           && (not $ isPrefixOf "bulletA" y)
  (_, _) -> False

この groupBullet はアローではなく、 XML 木から XML 木への単なる関数です。あとでアローに持ち上げます。

その前に、「bulletなんとか」という class 属性を持つ要素の名前を、その属性の値に変換するアローを書いておきましょう。 これがないと、いま定義した groupBullet 関数を使っても意味がありません(だって、元の木では要素名が全部 div ですから)。

classValToName :: (ArrowXml a) => String -> a XmlTree XmlTree
classValToName cls = 
    setElemName $< ((isClassPrefixOf cls 
                     >>> getAttrValue "class" 
                     >>> arr mkName)
                    `orElse`
                    getElemName)

isClassPrefixOf :: (ArrowXml a) => String -> a XmlTree XmlTree
isClassPrefixOf val =     
    (hasAttrValue "class" (isPrefixOf val))

この classValToName というアローを使って、次のようなアローを main の runX の中に仕込めば、つぶされていた構造を ul 要素として取り出せます。

processTopDown
(((getChildren >>> classValToName "bullet")
  >>. groupBullet)
 `when` (hasName "body"))

ここでポイントになるのが >>. という演算子です。 この >>. 演算子は、前段にあるアローの行先に対して、リストからリストへの関数を適用したアローを返します。 さきほど定義した groupBullet は [XmlTree] -> [XmlTree] な関数だったので、 >>. でアローと接続することで、「bulletなんとか」をグループにして ul でくくるというアローになります。 なお、あからさまな条件を when で指定して全体をわざわざ囲っているのは、こうしないと groupBullet したい要素たちを取ってこれないからです。

最後に、 class 属性の値が「bulletなんとか」の div 要素をすべて li に変換しましょう。 基本は最初に書いた chapterToH1 とまったく同じですが、今度は条件分岐に choiceA アロー使い、上で定義した isClassPrefixOf を条件にしてこんなふうに書いてみました。

bulletToLi :: (ArrowXml a) => a XmlTree XmlTree
bulletToLi =
    choiceA [isClassPrefixOf "bullet" :-> (tameClass "li"),
             this :-> this]

この例の全体を gist に張っておきます。

まとめ

ここでは、ほとんど >>> を使うだけで済む例しか出てきませんでしたが、実際にはかなりたくさんのアローの組み合わせ方が HXT で提供されています。基本的な XML の操作に便利なアローも、あらかじめたくさん実装されています。さらに、 >>. のようなリストとの連携機能も豊富です。おかげで、 Haskell の関数としてなら容易に書けるような処理を、 XML 木の変換をするアローとしてそのまま使えるようになります。

今回の記事で最後に書いたような HTML データの簡単な変換処理は、編集の現場ではちょくちょく遭遇します。 実際、 InDesign のような DTP ソフトが吐き出す XML を整形するのに、 HXT を利用して同じようなスクリプトを書いています。 些細な原稿データを一回だけ変換するなら、エディタの正規表現による置換で済ませてしまうほうがお気楽ですが、もっと複雑だったり素性が知れなかったするXMLデータを繰り返しいじるなら、 HXT も選択肢にいれてあげてください。

というわけで、去年に引き続き、今年の Haskell Advent Calendar 2013 も「編集者のための Haskell 入門」をお届けしました。

2013/12/02

TUG 2013で日本語の巻末索引について発表しました

TUG 2013という、世界中からTeX関連の開発者と利用者が日本に集まるイベントで、日本語書籍の索引について発表する機会がありました。「発表してみないか」と実行委員の黒木さんに誘われたときは、仕事でやってることを10分くらいで紹介すればいいのかなと思って軽い気持ちで引き受けたのですが、実は「海外からの参加者向けに用意する日本語チュートリアルの一環なのでよろしく」という話でした。当日は早口でいろいろ詰め込んでしまったせいか、話の筋を見失った方もいると聞いたので(すみません)、いまさらですが発表のストーリーをまとめておきます。(TeX & LaTeX Advent Calendar 2013の2日目の記事です。1日目はzrさん、3日目はdoraTeXさん。)

  1. いろいろな言語の本の索引を比べてみると、索引項目(一般には単語)の「自然な」並べ方がある言語とない言語がある
    • アルファベットを使う言語(ラテンアルファベットだけでなくハングルも含む)や、広義のアルファベットを用いる言語(タイ語とか)では、文字は言語によっていろいろだけど、単語は字面だけを見て並べられる
    • 一方、アルファベットを持たない日本語と中国語では、単語の並べ方に工夫が必要
  2. そこで、日本語の本における索引の並べ方を概説
    • いわゆる50音順は、文字の順番じゃなく、シラブルの順番
    • 中国語の辞書などで採用されてるピンイン順との比較
    • 人名を並べるときなど、50音順を破って字面優先にする場合(いわゆる電話帳順)もあるよ
  3. さらに具体的に、LaTeXで日本語の索引をどうやって作ってるか
    • makeindexやxindyは使えないので、日本語専用のmendexというツールを使うしかない
    • 漢字の読み仮名を機械的に解決するには、辞書だけじゃなくて、わかち書きのために形態素解析器も必要
    • 原稿がマークアップで汚くなるのを回避するために、gitで索引用のブランチを作るといいよ
  4. いろいろ面倒だけど、索引重要
    • 索引は、本文から単語を探すツールであるだけじゃなくて、本文の圧縮版としての役割もあるんだよ
    • 本を書いたり編集したりする人は、どうせ書いたものを何度も読むことになるんだから、そのうちの一回を「索引を作る」にあてるべきだよ
    • 電子書籍には電子書籍の索引の形があるはずなので模索していくべき

発表後、主に欧米の方々から個別にいろいろ質問されました。

Q:索引項目は文字列として短いのに、それでも形態素解析器が必要なの?
A:日本語は、まず分かち書きをしないと辞書すらひけないから、そのためだけでも必要。

Q:バージョン管理には何を使ってるの?
A:git(実際にはgit-svnが多い)

Q:たとえば「山」の字は「さん」と「やま」と二通り読むらしいけど、索引ではどっちに載せるの?
A:どういう単語に「山」の字が含まれてるかによって、たいていは一通りに決まる。決まらない例として、「空リスト」は「からりすと」と「くうりすと」とが毎度議論になるけど、自分は両方載せちゃう。

Q:索引をちゃんと作ったほうがいいというお前の話はまったくそのとおりだ
A:ありがとうございます!

Q:xindyは文字の順番を定義できるけど、なんで日本語では使えないの?
A:設定ルールがアルファベット前提っぽいから、少なくとも何らかの工夫は必要そう。それ以上詳しいことは今はちょっとわからない。

Q:中国語の索引は画数って話だけど、同じ画数の漢字の順番はどう決まるの?(実際には質問されなかったけど、勝手に想定してた質問)
A:筆順で決まる。「横線」「縦線」「はらい」「点」「折れ」の順(らしい)。

英語で発表というのもあって、準備はものすごい大変だったけど、終わってみればとても面白かったです。声を掛けていただいた黒木さん、本当にありがとうございました。事前の練習にお付き合いいただいた関東在住のTeXユーザーの皆様にも本当にありがとうございました。

本音を言うと、「日本語チュートリアル」という4つしかない枠の1つをまるまる「索引」に割り当てるのは、はっきりいって頭がおかしい構成ではないかと思っていました。今でも思います。もしかしたら、日本で開催するTeXの国際会議の一コマとして、コンピュータによる日本語の「排列」(用語の標準的な並べ方)の話題に絞るほうがよかったのかなあとも思います。とはいえ、例えば上記のような質問は「(巻末)索引」という切り口だったからこそ出てくる問題なのだろうし、そもそも日本語の排列の一般論なんて自分にはお手上げだし、自分なりに全力は尽くしたと思いたい。

TUG 2013 雑感

内外のいろいろな方にお会いして、中古カメラの話とか子どもの話とか、TeX以外にもいろいろと盛り上がれてとても楽しかったです。

とくにフランク・ミッテルバッハさんがとてもかっこよく、すっかりファンになりました。LaTeXコンパニオンにサインもしてもらいました。自分の発表後に「お前の話はまったくそのとおりだ」といってくれたのも彼です(その前にプロジェクタの接続を手伝ってあげたのでリップサービスかもしれませんが気にしない)。これからはLaTeX3を使っていこうと思います。

Japanese LaTeXCompanion 1st ed. with autograph

2013/11/04

Personal Impression on TUG 2013

For me, TUG 2013 had started August 2012, when Yusuke Kuroki, a mastermind behind Japanese TeX users, asked me to describe indexes of Japanese books at the next TUG, which would be held in Tokyo. Having intended to apply for any presentation slot, over whatever topic, I agreed to his request. I didn't think that I'm a sort of authority on this topic, but in the context of TeX, I was sure that I had enough experiences on indexes.

So I undertook a brief tutorial on making back-of-the-book indexes using TeX. What I didn't expect was that the tutorial would be over an hour long. I wasn't sure if indexes in Japanese actually would be much interesting for the most of the attendees. In addition to that, I thought the whole tutorials seemed to be overly focused on the compositions and typesettings of Japanese, rather than TeX. Until the TUG 2013 actually started, I had been a little bit skeptical how much non-Japanese speakers would enjoy the whole tutorials.

My concerns proved to be unfounded. The art of formatting Japanese is likely to be realized by the non-Japanese TeX users, let alone by the developers of the various typesetting systems. It would be nice these tutorials let everyone think about what we need to avoid awful looking documents. To put it bluntly, that is one of the raison d'etre of TeX.

Of course, there's another reason why we use TeX. That is because TeX allows us to take advantage of computers in creating documents, unlike word processors which requires a bunch of hand work. And in this context too, there is some subtle point in regard to Japanese that we wanted to let the attendees know. I can't help but feel partially responsible for that. I think both my talk on arranging index entries and Kuroki-san's additional tutorial on input methods revealed the gimmicky way of handling Japanese in the computer and TeX.

As a matter of fact I'm not good at speeches even in my native tongue. I felt as if my stomach was yanked out of my mouth during my presentation. But finally I found myself enjoying that. It was the great experience to hand on my knowledge to the people, including legendary developers around the world. I was really excited when I was directly questioned by them after the presentation. Again I was upset, this time the other way round.

© Kenshi Muto

Anyway, I reckon TUG 2013 was the great international conference. I'd like to thank the organizers for their energetic effort, and my particular thanks to Kuroki-san for giving me a rare opportunity.

2012/12/30

2013年賀状

年賀状書いた。

%!
<< /PageSize [285 420] >> setpagedevice

% excerpt from Bill Casselman's 
% "Mathematical Illustrations - a manual of geometry and PostScript"
/ctransform { load
  1 dict begin
  /f exch def
  [{[3 1 roll f {moveto}]}
   {[3 1 roll f {lineto}]}
   {[7 1 roll
     f 6 2 roll
     f 6 2 roll
     f 6 2 roll
     {curveto}]}
   {[{closepath}]}
   pathforall
  ]
  newpath
  {aload pop exec} forall
  end
  } def

/f { % u = (x^2-y^2) / 200, v = 2xy / 100
  /y exch def
  /x exch def
  x dup mul y dup mul sub 150 div
  1.2 x mul y mul 100 div
} def

/fcn { % u = ((x-100)^2-y^2) / 7 , v = 1.2xy / 7
  /y exch def
  /x exch def
  x 100 sub dup mul y dup mul sub 28 div
  1.2 x mul y mul 7 div
} def

/setrandcolor {
  /m exch .4 add def
  /r1 {rand 1 mod 1 div m add} def
  /r2 {rand 3 mod 17 div m add} def
  /r3 {rand 10 mod 17 div m add} def
  r1 r2 r3 setrgbcolor
} def

/randcgrid {
  currentlinewidth 10 div setlinewidth
    0 .5 300 {
      /i exch def
      i 0 exch moveto 300 0 rlineto /f ctransform
      i 400 div setrandcolor stroke} for
    0 .5 300 {
      /i exch def
      i 0 moveto 0 300 rlineto /f ctransform
      i 300 div setrandcolor stroke} for
} def

/xoffset 200 def

0 1 20{
  /n exch def

  xoffset 10 add -10 translate randcgrid
  0 xoffset sub 20 translate
  0 0 moveto
  newpath
  /Titania findfont 11 scalefont setfont
  0.7 0.1 0.1 setrgbcolor
  12 5.5 moveto
  (2008 2009 2010 2011 2012 2013 2014) true charpath
  /fcn ctransform clip
  /fcn ctransform clip
  1 0.5 0.55 setrgbcolor
  fill
  stroke
  newpath
  1 0 0 setrgbcolor
  120 setlinewidth
  145 140 moveto
  145 400 lineto
  stroke

  initclip
  20 10 moveto
  /Georgia-Bold findfont 10 scalefont setfont
  0 0 0 setrgbcolor
  n =string cvs show
  (/20) show
  showpage
  0 0 moveto
} for

"Mathematical Illustrations"を読みつつパスを変換(実質的には等角写像でぐにゅっと曲げた)して生成した。/fcn が西暦の文字列を構成するパスを変換するための写像を表す関数で、/f が矩形の格子を背景のテクスチャへと変換する写像を表す関数。

SDIM0193

利用したフォントは Titania 。毎年、フォント探しに一番時間がかかってるような気がする。

毎年、親戚や家族付き合いのある友人向けに20枚くらいだけ印刷してて、今年のものは「2008年に生まれた息子も5歳を迎えます今年も来年も引き続きよろしくお願いします」と読みます。去年のものはだいぶ色きちがいになってしまったので、今年はあっさりとした配色にして、何か手書きするスペースを残しました。

2012/12/24

TeX で花火(手抜きバージョン)

ちょうど一年前、「LaTeX/TikZ で花火」というネタが流行ったのは記憶に新しいところです(参考1、参考2)。 TikZ は高機能なグラフィック機能を提供する LaTeX のパッケージで、繰り返し構文なども提供されており、アルゴリズム的に花火っぽい絵を描画するコードがいくつか登場しました。

自分でも TeX & LaTeX Advent Calendar 2012 のために花火をひとつくらい打ち上げてみようかなと思ってたのですが、TikZ と格闘するような時間もなく、あきらめてかけていたところ、この花火ネタより前の2009年に話題を集めた LaTeX お絵かきネタを思い出しました。コーヒーポットのシミを論文などに刷り込むための LaTeX スタイル "LaTeX Coffee Stains" です。これの花火バージョンがあれば、なんとかゴール目前までつながった TeX & LaTeX Advent Calendar 2012 のお祝いネタとしてちょうどいいのではないでしょうか。

というわけで急遽でっちあげたのが、見た目にもめでたい「花火をページに刷り込むコマンド」です。花火を打ち上げたいページで \fireworks と書くだけ!

正直に打ち明けると、このネタは上記の coffee.sty の丸ぱくりです。 しかも自分では TeX のコードをまったく書いてません。元ネタである coffee.sty を見たら、PSTricks という PostScript の描画命令を直接埋め込める機能を使ってコーヒーのシミを描いていたので、この PostScript のシミデータを自作の PostScript 花火データにまるっと差し替えました。 PostScript の花火をどう作ったかは聞かないでください。 PSTricks では PostScript の描画コマンドは直接利用できるけど PostScript のプログラムを書けるわけではないので、アルゴリズム的には生成してないです。なお、 PSTricks は dvipdfmx では使えないので、PDFを作る場合は pdftex か dvips 経由で。

というわけで、明日の TeX & LaTeX Advent Calendar 2012 最終日はTeX芸人の中のTeX芸人、ZRさんの予定です。

2012/12/18

parsec で極める文章編集

正規表現をまったく使えない編集者はひとにぎりだと思いますが、正規表現だと原稿の半角丸括弧を全角に変換する作業とか頭痛いですよね。わたしもいつも困ってました。

というわけで、いまや編集者必須ツールといってもいい parsec を新人編集者にぜひ使ってもらおうということで、 「Haskell Advent Calendar 2012」18日目という場を借りた素人チュートリアル記事です。 Haskeller が書いてるわけではないので、 「その考え方は違う」とか「もっと効率的な書き方がある」といったコメントがもらえるとうれしいです。 ちなみに、わたしの周りに新人編集者はもう何年もいません。まだ見ぬ新人へ向けて書きます。

parsec で最速テキストフィルター

最初に parsec を使おうと思ったときにぶちあたるのは、プログラマ向けの解説しかないことだと思います。 編集者というものは、 CSV や IP アドレスをパースしたり、ましてや関数電卓を作ったりしない。 Ruby で正規表現を使ったテキストフィルターを書くときみたいに parsec を使うにはどうすればいいでしょうか。

外側から考えます。いま作りたいのは、入力ファイルを指定して、何か文字列変換を施した結果を出力するテキストフィルターです。Ruby なら ARGF.gets とかすればいいとこですが、ここは我慢してとりあえずこんな枠組みを書きます。

module Main () where

import System.Environment
import qualified System.IO as IO
import Text.ParserCombinators.Parsec hiding (many, (<|>))
import Control.Applicative

main = do
  args <- getArgs
  inh <- IO.openFile (args !! 0) IO.ReadMode
  body <- IO.hGetContents inh
  IO.putStr $ doSomething body
  IO.hClose inh

doSomething が具体的な変換処理で、ここに「日本語文章に出てくる半角丸括弧を全角に」とか「TeX の数式を抜き出す」とか「コード行に出てくるキーワードにハイライトのタグをつける」とかいった処理をするパーザを parsec で書くわけです。

では doSomething を考えましょう。ここでは doSomething という名前を説明のために使い続けますが、実際にスクリプトを書くときはテキスト変換処理を表す適切な名前をつけてください。

doSomething :: String -> String
doSomething lines = case parse (concat <$> manyTill block eof) "" lines of
  Left  err -> ""
  Right str -> str

テキストフィルターなので doSomething は文字列から文字列への変換を担う関数でないと困ります。 そこで 1行目には String -> String と書いてあります。

case ... of の内側の manyTill block eof が、とっかかりとなる最初のパーサです。 これは、「今はなんだか決めてないけど block という文字列の塊を取ってくるパーザがあるとして、それをファイルの終わり eof まで繰り返し実行する(manyTill)」、という意味です。 繰り返しとってきたその結果は、文字列のリストなので、一つにつなげるために concat <$> と書いています。 このように関数のうしろに <$> と書き、続けてパーザを書くと、「うしろに書いたパーザが返すものに最初の関数を適用したものを返すパーザ」になります。

ここで注意しないといけないのは、パーザは「文字列をパースして得られる文字列」を返してくれるわけではないという点です。 parsec では、パーズして得られる結果は「パーザを実行する専用世界」の中にあり続けます。 その専用世界を Parser と呼ぶことにしていて、 だから parsec におけるパーザは、たとえば文字列を返すものであれば Parser String といいます。文字を返すものなら Parser Char です。何も返さないパーザというのもあって(スペースを読み飛ばす、とかです)、これは Parser () といいます。

この Parser 世界の中にフィルタリングしたい文字列を入れて、パーズした結果をもらいたいわけですが、この世界とのやり取りは決められた出入り口からしかできないようになっています。 someParser というパーザを書いたとして、それで文字列をパーズして結果を「専用世界」の外に引っ張り出してくる方法のひとつが、上記の parse someParser "" lines という書き方です。

こうして手に入る結果は「パースに成功してこんな文字列が手に入った、または失敗した」というちょっと変わった形をしています。そのままでは doSomething の結果としてふさわしくありません(だって doSomething は文字列を返すってことにしたので)。そこで case ... of と Right および Left という識別子を使って、成功の場合も失敗の場合も文字列を返すようにしています。作ってるのがテキストフィルターなので、失敗の場合は空文字列を返しとけばいいでしょう。

ここでようやく block を何にするか決めます。 テキストフィルターの仕様を考えるわけです(というわけで、ここまではテキストフィルターを書くときの定型だと思ってもいいです)。

いま、HTML の <p> タグの内側にある半角丸括弧だけをすべて全角丸括弧に直したいとします。 一方、 <pre> タグの中にある半角丸括弧とかは、コードの断片である可能性が高いので、変換してはいけないとします。数式なんかに出てくる半角丸括弧も全角にしてはいけません。 いま仮に、 <p> タグの中には日本語の本文だけしかないものとしましょう(でないと説明のコードが増えてしまうからです。べつに一定のルールにしたがって出てくるぶんには、その部分だけ処理を飛ばすようにパーザを書けばいいのです。ただし完璧を目指すと泥沼になるので適当な精度で切り上げましょう)。

この場合の block の仕様はこうです。こいつは文字列を返すパーザにしたいので、 Parser String だと宣言しておきます。

block :: Parser String
block = choice [ try japara
               , otherlines ]

japara :: Parser String
japara = string "<p>" *> (conc <$> manyTill anyChar (try $ string "</p>"))
  where conc = ("<p>"++) . (++"</p>") . replaceParen

otherlines :: Parser String
otherlines = manyTill anyChar $ (try $ string "\n")

ざっくりというと、日本語の本文(japara パーサ)かそれ以外(otherlines パーサ)かで選択(choice 関数)をして、日本語の本文だったら半角括弧を全角に変換します(replaceParen 関数)。 block だけでなく、そこから呼んでる japara だったり otherlines だったりは、すべて文字列を返すパーザです。こんなふうに、基本的なパーザをいろいろ組み合わせて好きなパーザを作るわけです。 string [文字列] とか anyChar なんかも、もちろんパーザで、これらのいわば最小の部品は parsec にあらかじめ用意されています。ほかの部品はここにドキュメントがあるので探してください。

japara、つまり日本語の本文は、「文字列 <p> から </p> までの内側」です。 *> は、右側だけを結果に残すようなパーザを作ってくれます。

otherlines、つまり日本語の本文以外は、「改行までの文字なら何でも」とってくるパーザです。 この定義だと 1行とったら終わってしまうように思いますが、外枠のほうで block を何度も繰り返しとり出すことにしてあるので、これで問題ありません。

<p> タグ内で半角括弧の置換を行う replaceParen を書くには、 最初のほうで定義した doSomething と同じ考え方をします。 doSomething では本文全体から必要なブロックと不要なブロックを切り出すパーザを繰り返し使ったわけですが、今度は置換する要素としない要素に切り刻むパーザを作り、それで各ブロックを処理していきます。 丸括弧は入れ子になってるかもしれないので、丸括弧か否か(parens と noParens)だけでなく、丸括弧内か(inParens)も選択肢になりえます。

replaceParen :: String -> String
replaceParen line = case parse (concat <$> many1 strOrParen) "" line of
  Left err -> ""
  Right str -> str

strOrParen :: Parser String
strOrParen = choice [ try noParens, try inParen, parens ]

inParen :: Parser String
inParen = string "(" *> (wrapDP <$> (manyTill strOrParen (string ")")))
  where wrapDP = ("("++) . (++")") . concat

noParens :: Parser String
noParens = many1 $ noneOf "()"

parens :: Parser String
parens = many1 $ oneOf "()"

以上を ReplaceParen.hs のような名前で保存して以下のように実行すれば <p> タグの中だけ半角丸括弧を全角に置換できます。このブログ記事のソースみたいなのを処理しても、コード片に出てくる半角丸括弧は置換されません。やったね。

$ runghc ReplaceParen.hs input.html > result.html

parsec でテキストフィルターを書くときのまとめ

  1. 全体をブロック要素へと切り刻むパーザを choice で作り
  2. 各ブロックをインライン要素へと切り刻むパーザを choice で作る
  3. どちらも 「case parse [パーザ] "" [パーズする対象] of 」で文字列から文字列への関数にしたてる

書き捨てとはいえ、このような再帰的なパターンになると、正規表現をサポートしてるエディタではつらいし、sed/Ruby/Python/Gauche などでスクリプトを書くにしてもかえってコード力が要求されることが多いように思います。 単純よりちょっと込み入ったテキスト処理になると、Haskell のほうが parsec のおかげで楽に編集補助ツールが書けることもあるはずです。プログラマでないみなさんも『すごい Haskell たのしく学ぼう!』と『プログラミング Haskell』だけは読んでおきましょう。再帰に対する理解もあるとなおよいので、『Scheme 手習い』もぜひ読みましょう。これは宣伝です。

Haskell のコードには、ここで出てきたような <$> とか *> のような記号がちょこちょこ出てくるのでとっつきにくいかも知れませんが、『すごい Haskell たのしく学ぼう!』の Kindle 版とか、ちゃんと索引もついてるので、こんな検索しにくそうな記号もばっちり調べられます。これは宣伝であると同時に、電子書籍にも索引あったほうがいいよという、この記事の対象者である新人編集者むけのアドバイスです。

注意

書き捨てのテキストフィルターに完璧は目指さないこと。あくまでも編集作業の補助に使いましょう。 実は上の例でも、たとえば原稿中に <p> 要素の入れ子がないことや、<p> タグがすべて行頭にあることを密かに仮定していて、だから otherlines が簡単に定義できてます。

経験からいうと、 otherlines のような「探してないその他大勢」をすっ飛ばすパーザを書くほうが大変で、行頭とか空白とか特殊文字といった都合のいい条件のない完璧なパーザを目指そうとすると、とたんにスクリプトが巨大になります。この例だと、それこそ XML パーザを書く勢いが必要です。しかし、いまほしいのは書き捨てのテキストフィルターです。妥協が肝心です。ビルドスクリプトに組み込むとかでなければ、一発で完全に処理しようとしないほうが幸せです。

2012/12/15

TeX がむかついたので実装したけど挫折してる話

いきなり私見ですが、「TeX むかつく」という声の大半は、「インストールが苦痛」または「マクロが意味不明で思い通りならない」に分類できるんじゃないでしょうか。 でもまあ、便利なインストーラ付属の分かりやすいLaTeX2eの入門書が改訂を重ねて書店で売ってたりするのだし、これらは普通の用途においては解決策がある問題ということにしておきましょう。

インストールの壁をクリアして、ちょっと凝ったページの出力もできるようになると、 基本的な組版機能に不足はないし、数式にいたってはほぼ唯一無二だし、自作マクロでちょっとした自動化さえできるわけで、 「とにかくTeXむかつく」という心境から、「いっけん意味不明な制約やなぞの挙動には目をつぶるとして TeX しかないな」という心境に至る人も多いはずです。 わたし自身も、組版に関しては、だいたいそういう心境です。残念ながら TeX しかない。

しかし、それでも TeX には実際むかつくことがある! それは、「TeX がドキュメントシステムに向いてない」ことです。「自由すぎる」ともいえます。

ドキュメントというのは、木構造になっているべきです。 キーワードやフォント指定用語などのインライン要素から構成される章、節、段落、図、数式といったブロック要素が、根っこで一つのドキュメントへと束ねられてるようなイメージです。 散文一般とドキュメントに区別があるとしたら、この木構造が必須か否かという点かもしれません。 ドキュメントは、なんらかの木構造と一対一対応がないと、最悪、読み手によって意味が変わってしまいます。 小説ならそれでいいんですが、たとえばジェット機の整備マニュアルなんかだと、それではまずい。 だから、まっとうなドキュメントには木構造が求められるわけです。XMLとかSGMLが重宝されるゆえんです。

だからドキュメントをシステマチックに扱うには、木構造を反映できるファイル形式が不可欠です。 さらに、ドキュメントを木として編集するための仕組みもあればうれしいでしょう。

TeX がドキュメントシステムに向いてないと思うのは、この木構造の観点が欠落しているからです。 もちろん、書き手が注意して執筆することで、 TeX を使って木構造のドキュメントを作ることはできます。 しかし、 TeX で執筆された原稿を扱う汎用の仕組みを作ろうとすると、構文解析すら無理ゲーなことに気づきます。 ドキュメントシステムの処理系を作ろうとしたら、原稿から木を作ってそれを内部表現として扱うと思うのですが、 TeX の場合、原稿を書くための基本的な構文も内臓のマクロ言語によって提供されているため、原稿から木を作りたいだけなのに、原理的にはこのマクロ言語の処理系を書かないと完全なものにならない。そこで実践では「サポートする TeX の構文」を決めうちすることで TeX マクロ言語処理系を実装する手間は省くことになってしまい、だから世の中には「汎用の LaTeX→XML コンバーター」のような仕組みが見当たらないのです。

ないから作った

ないなら作ればいいというわけで、TeXマクロ言語の処理系を Gauche で実装してみたことがありました。TeX-modoki といいます(その後「tef」に改名)。基本的なマクロの展開が扱えます。久しぶりにソース見たら \afterassignment も \aftergroup も未実装だったけど、奇数個の \expandafter の塊くらいはまじめに処理できます。

tex-modoki$ cat sample/expandafter-test.tex
\def\A#1#2#3{#1#2#3a}\def\B#1#2{#1#2b}\def\C#1{#1c}\def\D{d}

\expandafter\expandafter\expandafter\expandafter
\expandafter\expandafter\expandafter\A
\expandafter\expandafter\expandafter\B\expandafter\C\D

tex-modoki$ gosh -I. main.scm -o text sample/expandafter-test.tex
 dcba

トークンのカテゴリコードもまじめに扱ってるので、それ相応の判定結果が得られます。

tex-modoki$ cat sample/ifcat-test.tex
\catcode`[=13 \catcode`]=13
\def[{*}

\ifcat[* yes \else no \fi % yes

\ifcat\noexpand[\noexpand] yes \else no \fi % yes

\ifcat\noexpand[* yes \else no \fi % no

tex-modoki$ gosh -I. main.scm sample/ifcat-test.tex
 yes   yes  no

未実装の機能が多いので制限だらけですが、簡単な整数計算のマクロなら実行できるっぽいです。「スヤァTeX」に登場する、修正ユリウス通日を求めるマクロも、少し修正は必要ですが実行できました(できるように今朝ちょっと実装を追加した)。「\relax」の変わりに「( ˘ω˘ )スヤァ…」を使うには(ry

tex-modoki$ gosh -I. main.scm -o text sample/julian.tex
   56286

tex-modoki$ cat sample/julian.tex
\input sample/plain % tex-modoki 用に修正した plain TeX マクロを指定

\newcount\xx@cnta
\newcount\xx@cntb
\newcount\xx@year   % 4桁の整数の格納に mathchar を使わない!
\newcount\xx@month  % 2桁の整数の格納に char を使わない!

\def\julian#1{%     % LaTeXじゃないので newcommand を def に
  \edef\xx@tmpa{#1}%
  \expandafter\xx@julian@a\xx@tmpa///\relax
}
\def\xx@julian@a#1/#2/#3/#4\relax{%
  \xx@cnta=#1\relax
  \xx@cntb=#2\relax
  \ifnum\xx@cnta<1 \xx@cnta=\@ne \fi  % 条件式の \@ne を 1 に
  \ifnum\xx@cntb<1 \xx@cntb=\@ne \fi  % 条件式の \@ne を 1 に
  \ifnum\xx@cntb<3\relax
    \advance\xx@cntb by 12\relax
    \advance\xx@cnta by -1\relax
  \fi
  \xx@year=\xx@cnta
  \xx@month=\xx@cntb
  \multiply\xx@cnta by 1461\relax
  \divide\xx@cnta by 4\relax
  \xx@cntb=\xx@year
  \divide\xx@cntb by 100\relax  
  \advance\xx@cnta by -\xx@cntb
  \divide\xx@cntb by 4\relax
  \advance\xx@cnta by \xx@cntb
  \xx@cntb=\xx@month
  \advance\xx@cntb by -2\relax
  \multiply\xx@cntb by 520\relax
  \divide\xx@cntb by 17\relax
  \advance\xx@cnta by \xx@cntb
  \advance\xx@cnta by #3\relax
  \advance\xx@cnta by -678912
  \edef\thejulian{\number\xx@cnta}%
}

\julian{2012/12/25}
\thejulian

というわけでこの記事も TeX & LaTeX Advent Calendar 2012 の15日目に向けて書きました。12日ぶり2回目。

TeX の数式を HTML で出力

さらに副産物として、「素TeXで書いた数式の HTML 出力」ができます! もともと TeX の組版機能を実装するつもりはなく、その力もないのですが、TeX の数式を木構造へと変換できるところまでいったので HTML+CSS でも出力できるようにしてみました。

出力例はこんな感じで、残念なとこもあるけど、まあ見られるかなというレベル。

tex-modoki-1

ソースは、こちらのような、単純な TeX ファイルです。 しかし、 LaTeX はもとより、ごく基本的な TeX の標準マクロさえないので、手元にある LaTeX の数式を変換しても内部表現を吐き出すだけだと思います。

結局挫折

けっこうがんばってここまで作ってたのですが、今では開発をほぼ中止しています。なぜなら、TeX では字句解析時の文脈もマクロからいじれてしまう(ヘンタイ!)という事実に後から気が付いたので、完全なものにするにはゼロから作り直す必要があるからです。TeX むかつく!

数式変換機能の線でもうちょっとがんばって開発を続けようかなと思ったこともありましたが、 LaTeX や ams の膨大な遺産を前に挫折! やっぱり TeX むかつく!

2012/12/03

TeXを電卓として使おう(あるいは、TeXでベキ乗根)

プログラミング言語 TeX にはインタプリタがついてきます(ツッコミ禁止)。そこで他の多くの言語のインタプリタのように、TeX インタプリタを「電卓」として使ってみましょう。(なお、この記事は TeX & LaTeX Advent Calendar のために書いたものです。明日は @neruko3114 さん!)

まずは TeX インタプリタの起動です。日本語の組版をするなら ptex を実行するところですが、電卓に日本語はいらないので、今回は世界標準らしい pdftex を使います。 TeX インタプリタの標準プロンプトは * (アスタリスク)ですが、起動時だけは興奮気味に ** と2つ重ねて出力されるので、お約束として一言目は毎回 \relax と入力して TeX インタプリタを落ち着けてください。

$ pdftex
This is pdfTeXk, Version 3.141592-1.40.3 (Web2C 7.5.6)
 %&-line parsing enabled.
** \relax
*

さっそく 1+2 と入力してリターンを押したいところですが、TeX で単に数字や演算子を書いてしまうと、通常の文脈ではドキュメントへと印字する文字列とみなされます。いかにもドキュメント処理システムっぽいですね。数字を整数値として扱うには、整数用の \count レジスタというハコを用意してそこに値を格納し、そのレジスタ上で演算を行います。整数の加算からやってみましょう。

* \newcount\a
* \a=1
* \advance\a by 2
* \showthe\a
> 3.
<*> \showthe\a

?      % ここで単にリターン

*

1行めの \newcount\a で新しい \count レジスタ \a を用意し、2行めで\a に整数値の1を代入、 \advance\a by 2 という命令で \a 「2」の値に2を加算し、 \showthe というコマンドで \a の中身を出力しています。結果は赤字の「3」です。 \showthe で結果を表示したあとはプロンプトが ? に変わりますが、気にせずリターンを押せば元の * に戻ります。簡単ですね。なお \advance コマンドの引く数にマイナス記号をつければ(\advance\a by -2)、減算ができます。減算専用のプリミティブは用意されていません。

続いて、整数の乗算と除算です。それぞれ \multiply、\divide という命令が用意されています。先程のセッションに続けて以下のように入力してみましょう(したがって、いま \a には 3 が入ってます)。

* \multiply\a by 3
* \showthe\a
> 9.
<*> \showthe\a

?      % ここで単にリターン

* \divide\a by 2
* \showthe\a
> 4.

最後の行は「9÷2」の結果なので「4.5」になるはずですが、 \count は整数用のハコなので端数は切り捨てられます。キャストとかされません。というか、そもそも実数そのものを扱うハコがありません。

では、結果が実数になるような複雑な計算は実現できないのでしょうか。試しにベキ乗根のつもりで \sqrt\a とかしてみましょう。

* \sqrt\a
! Missing $ inserted.

$がない、つまり数式組版モードじゃないと言われました! 当たり前と言えば当たり前なのですが、TeX というのは本来はドキュメントシステムなので、 sqrt はもちろん、 + や * 、 さらには数字にいたるまで、ふつうの言語なら数値やその演算を提供するであろう要素はほとんど組版の機能に利用されてしまっています。

しかし TeX は、「かっこいい出力ができる汎用プログラミング言語」でもあるはずです。ベキ乗根の近似値くらい計算できないはずがない。そこで、ベキ乗根の近似値をかっこよく組版で使うための TeX マクロ \sqrtd を作ってみましょう。目標は、こんな入力から、

You can get \sqrtd{2}, \sqrtd{2.5}, \sqrtd{3} and \sqrtd{3.14} 
by Newton's method with initial guess $1.0$.

こんな出力を得ることです。

newtonmethod-output

(2のベキ乗根があまり精度よくないのは目をつぶってください><)

TeXでニュートン法を実装しよう!

ベキ乗根の近似値を得る方法として一番簡単なのはニュートン法でしょう。まずはニュートン法を使って値 x のベキ乗根を求める手順のおさらいです。

  1. ベキ乗根になりそうな値 y を適当に推測します。
  2. その推測値 y のベキ乗 y2 と、元の値 x との差を調べます。
    • この差が十分に小さかったら、その推測値 y はだいたいベキ乗根に近いということで、答は y です。
    • この差が十分に小さくなかったら、推測値 y と x/y の真ん中の値をあらためて推測値 y とし、1.に戻ります。

いきなり TeX はきついので、とりあえず Scheme で書いてみます(詳しくはSICPの1.1.7節を参照)。

(define (sqrt-iter guess x)
  (if (good-enough? guess x)
      guess
      (sqrt-iter (improve guess x)
                 x)))

(define (good-enough? guess x)
  (< (abs (- (square guess) x)) 0.001))

(define (improve guess x)
  (/ (+ guess (/ x guess))) 2))

このアルゴリズムを TeX で実装したいわけですが、 TeX にはそのものずばりな実数値がありません。ただ、TeX本来の機能である自動組版を制御するために、値が実数になる「寸法(dimension)」というデータ型は用意されています。このデータ型上にも、整数値のときと同じ演算命令(\advance、\multiply、\divide)が制限付きながら用意されているので、そこに上記のアルゴリズムの x や y を格納すれば原理的にはベキ乗根が求められるだろう、という算段です。

ここで厄介なのが、寸法上の演算の制限です。寸法の値を自由に掛け算したり割り算したりすることはできません。寸法に対して可能な乗算と除算は、具体的には以下のとおり。

  1. 寸法は、整数倍したり、整数で割ったりすることはできる。
  2. 寸法の前に、何か数字っぽいものを書くと、その数字の値が寸法の値に掛けられる。

上記の 1. は、寸法の値に実数を掛けたり割ったりすることは基本的にできない、つまり、実数どうしの乗算と除算が寸法型のままではできないということです。

上記の 2. の手段を使えば、寸法に実数を掛けることはできます。ここでちょっと実際の TeX コードを見てみましょう。寸法データ型を用意して「3.14 ポイント」を格納し、その寸法を 1.5倍するには、例えばこう書きます。

\newdimen\x      % 新しい寸法データ\xを用意
\x=3.14 pt       % 寸法\xに単位付きの実数を格納
\x=1.5\x         % 寸法\xを1.5倍

寸法の単位はいくつかありますが、ここではポイント(pt)を使っています。2行めでポイントの単位「pt」を省略して 3.14 という実数値を寸法に代入しようとしてはいけません(TeX に苦情を言われます)。3行めの結果、 \x には「4.71 ポイント」に相当する値が入ります。

ここで、実数に実数を掛けようとして次のように書いたらどうなるか考えてみましょう。

\newdimen\x      % 新しい寸法データ\xを用意
\newdimen\y      % 新しい寸法データ\yを用意
\x=3.14 pt       % 寸法\xに単位付きの実数を格納
\y=1.5 pt        % 寸法\yに単位付きの実数を格納
\x=\number\y\x   % 寸法\xを1.5倍?

最後の行に出てくる \number は、直後のデータ型の数字表現を返すコマンドだと考えてください。上記を TeX に渡すと「Dimension too large.」というエラーになり、 \x は 16383.99998pt という寸法になるはずです。これは、 TeX の寸法の上限(をポイント単位で表したもの)です。

何が起こったのでしょう。\number\y は 1.5 ではなく、「ポイントで表すには "too large" だ」と TeX に言われてしまう何か巨大な寸法であり、TeX はとりあえずの処置としてポイント表示で最大な数字を \x に入れたのです。ちなみにその巨大な寸法とは、 1.5 ポイントを sp という単位で表した数字に 3.14 ポイントを掛けた寸法であり、308674.56pt です。実をいうと、TeX は内部では sp という単位の整数倍で寸法を扱っています。だから、寸法で実数が扱えるというのも実はまやかしで、ポイントくらい大雑把な単位で見れば小数表示になる寸法を実数とみなして扱える、ということだったりします。

というわけで、寸法そのものは単位付きの値なので、その単位で表した場合の実数値を示す数字として使うには、何とかして単位の部分をひっぺがす必要があります。そのための仕組みがこちらの \strippt です。

\newdimen\zero \zero=0pt
\begingroup
  \catcode`P=12
  \catcode`T=12
  \lowercase{
    \def\x{\def\rempt##1.##2PT{##1\ifnum##2>\zero.##2\fi}}}
  \expandafter\endgroup\x

\def\strippt{\expandafter\rempt\the}

何を言ってるのか分からないと思うが、私もこんなのゼロから書けるわけありません。これは LaTeX のコアで定義されているマクロをほぼそのまま拝借してきたものです。 \expandafter のとこだけ説明しておくと、ポイントを表す「pt」の各文字をちょっと特殊な文字とみなす閉じた環境で「なんとか.なんとかpt」というトークン列にマッチさせて \rempt というマクロを定義したいのだけど、それを外から使えるようにするために環境を閉じる \endgroup の展開を遅らせているのが最初の \expandafter で、その\remptを「なんとか.なんとかpt」という形の引数に対して使うべく \the で先に展開するために配置されているのが 2つめの \expandafter です。

以上の下準備でようやく、ニュートン法を実装するのに必要なベキ乗のためのマクロ \square が定義できるようになりました。

\newdimen\tempdimen \tempdimen=\zero

\def\square#1{\tempdimen=#1%
  #1=\strippt \tempdimen \tempdimen
  \tempdimen=\zero}

この \square を使ってニュートン法のアルゴリズム全体を書き下してみます。

\newdimen\prevguess
\newdimen\val
\newdimen\guess

\def\sqrtiter{%
  \prevguess=\guess
  \square\prevguess
  \advance\prevguess by -\val  % 推測値のベキ乗と元の値との差
  \ifdim\zero>\prevguess       % 差の絶対値
    \prevguess=-\prevguess\fi
  \ifdim\prevguess<0.001pt     % 差が十分小さかったら、
    \let\next=\relax           % おしまい。
  \else                        % 十分小さくなかったら、
    \improve\guess\val         % 推測値を改善して、
    \let\next=\sqrtiter        % 再帰。
  \fi\next}

上記でまだ未定義なのは、ニュートン法のアルゴリズムで推測値を改善させる部分を担うマクロ \improve です。次はこれを実装します。\improve には「実数÷実数」の演算がでてきますが、寸法の値を使った除算には直接の手段はなさそうなので、やや面倒な工夫が必要です。全体はこんな定義になりました。

\newcount\tempcountA
\newcount\tempcountB
\newdimen\tempdimenA
\newdimen\tempdimenB

\def\improve#1#2{%
  \tempcountA=#2%                   % いったん割られる数を整数にして、
  \multiply\tempcountA by 1000%     % 十分な倍率で大きくしておく。
  \tempcountB=#1%                   % 割る数も整数にする。
  \tempdimenB=#1%
  \divide\tempcountA by \tempcountB%% ここで割り算。
  \tempdimenA=\tempcountA pt%       % 結果をポイント単位で寸法に戻す。
  \divide\tempdimenA by 1000%       % 倍率を戻す。
  \advance\tempdimenA by \tempdimenB% 
  \divide\tempdimenA by 2%
  #1=\tempdimenA}

\newcount は、整数を格納できるハコを作ります。そこに「寸法」を代入すると、先に説明したsp単位の整数に変換されて格納されます。整数どうしは \divide というプリミティブで割り算できるので、これだけでもよさそうに思えますが、 \divide は剰余を切り捨てて結果を整数に丸めてしまうので、これだけだと結果の誤差が大きくなりすぎます。そこで、割られる数だけ十分な倍率を掛けておいて、割り算して結果を寸法に変換し直したあとで倍率を戻しました。

\improve の実装に必要な残りの演算は、単純な足し算と整数2による除算なので、特にこれ以上の工夫はいりません。これで寸法 \val と \guess にそれぞれベキ乗根を求めたい数と初期推測値を入れておいて \sqrtiter を起動すると、ベキ乗根の値にポイントの単位がついたものが \guess に代入されます。あとは、こんなコマンドを定義すれば目標達成です。

\def\sqrtd#1{\val=#1 pt%
  \guess=1.0pt%
  \sqrtiter%
  $\sqrt{\number#1} \approx \strippt \guess$%
}

You can get \sqrtd{2}, \sqrtd{2.5}, \sqrtd{3} and \sqrtd{3.14} 
by Newton's method with initial guess $1.0$!

今回書いた TeX スクリプトの全体はこちら。なお、 LaTeX で実数を本気で使いたいなら、こんな面倒なことをしなくても、fpパッケージという便利な浮動小数点数演算のための仕組みがあります。そちらを使いましょう。

2012/11/05

TeXユーザーの集い2012 雑感

2012年10月27日、京都大学で開催された「TeXユーザーの集い2012」に参加しました。

TeXユーザーの集い2012開会

勤め先ではpLaTeXをバックエンドに採用した継続的書籍制作をしているので、 前回、前々回の「TeXユーザーの集い」ではポスター発表という形で成果物である書籍の展示をしていたのですが、 今年は会場が京都なので、東京から何冊もの書籍を持っていくのは物理的にいやだ。 そこで代わりに「ショートショート」というコーナーで10分間のプレゼン発表と書籍の宣伝をさせてもらいました。

「出版社の中でpLaTeXとバージョン管理システムを全面的に活用して本を作っています」という話そのものは、 いまやそれほどもの珍しい話ではなくなっていると思います。 ちょっと前に新規企画のキックオフの場で著者(正確にいうと訳者)に制作フローの説明をするとき、 「前にも別の出版社で同じような方法でやったことがあるから分かります」と言われたときは、 本気で涙が出るかと思いました。 田中さんのショートショート発表にあったような業務ドキュメント作成のバックエンドで利用されている事例も案外に多いのかも。

そこで今回のプレゼン発表では、自分たちの書籍制作フローを紹介するだけでなく、実例を交えて方法論の私的な意味づけができればと思って挑みました。 この時点でもともと「ショートショート」コーナーに設定されていた「私のTeX環境」というお題から微妙に逸脱していたことは実行委員の皆様にお詫びいたします。 でも当日、LaTeXの論文原稿からプレゼンを吐き出すという寒川先生の話、 印刷の歴史から現在のXSL-FO対応にいたる中西印刷の中西さんの話、 XMLによる医療系ドキュメントの標準化に携わってらっしゃる時実先生の話などを伺っているうちに、 もしかして自分の発表はカウンターを狙ってたつもりが正面からジャブみたいになってる?という気がしてきました。

思えば去年の「TeXユーザーの集い」も「TeXという視点から構造化ドキュメントのエコシステムを捉えよう」というノリでした。 そうなんだよなー。 かつてTeXを採用する理由とされたのは「数式がきれい」のような特徴でしたが、こういう面ですでにTeXは One of Them になっています。 無料であるのはいまもってTeXくらいに思えますが、Wordなんかは事実上無料なわけで、そのWordの数式エディタも性能としては十分です。Apple製品でもなにかあるんですよね。よく知りませんが。 そういえば黒木さんの発表でも韓国や欧州のTeXユーザーグループの集まりでは「TeXの話が半分、XMLなど周辺の話が半分」といってた気がする。

そういう中でわたしが仕事でTeXを使っているのは、ひとつにはプレゼンで触れてるように「バージョン管理しやすい」というのがあります。 実際、このプレゼン発表の資料も、pLaTeX + beamer で書いて bitbucket でバージョン管理してました(ソースが見られて恥ずかしいけど、おかげで公開後にいっぱいフィードバックもらえた。ありがたいことです)。 でもテキストの原稿をバージョン管理したいなら、べつにTeXをバックエンドに使う必要はなく、中西印刷さんのようにアンテナハウスさんのFOフォーマッターを利用するのでもいい。

結局、編集者としての自分が仕事でTeXを使ってることに、それほど積極的な理由はありません。 経済的な制約だったり自分のスキルの制約だったり、どちらかというと消極的な理由からです。 だから、たとえば人にTeXを使えと勧める気には正直なところあまりなりません。 やっぱり編集の仕事でTeXを使おうとするには、それなりの覚悟と職場的な理解が必要だと思います。 自分は出版社にいるのである程度好きなように環境を選べますが、プロダクションでの編集となるとそうもいかないでしょう。 (もちろん世の中には、そういう覚悟を決めて出版社から制作の仕事を請け負ってしまうすごいプロダクションもあります。)

一方、趣味プログラマーとしての自分にとってTeXマクロは単純に面白いので、その部分については「おもしろいよ!」と主張したい。 ふつうのプログラミング言語だと思って使おうとするとストレスフルですが、モデルが違うんだから違うモデルで考えることを楽しめばいい。 TeXを使って遊ぶ文化は今年に入ってから日本でじわじわ広まっていると感じています(いにしえからあるので新しい文化というわけではないですが)。今年は「TeX芸人」という言葉も生まれました。今回は「TeX芸人」という言葉が誕生してはじめて開催された「TeXユーザーの集い」だったからか、残念ながらストレートにそういう発表はありませんでしたが、今年のクリスマスはTeXアドベントカレンダーが読めるかもしれません。どんな\expandafterが見られるか楽しみですね。

というわけで、自分のTeXに対するスタンスは、そんな「実務で十分に使える自分にとっては楽しい道具」かなと再確認しました。 懇親会で何人かの方と「TeXを普及させるには」的な話になったりもしたけれど、 新興の技術というわけでもないのだし、(1)使ってみようという人にとって負荷が低いこと、(2)楽しく使えてる人が楽しく使い続けられること、(3)新しい仕組みとの親和性を保ち続けること、あたりがTeXユーザーにとって本来の争点なんだと思います。

1は、ディストリビューションやインストーラの開発者のみなさんのおかげで、すでに障壁らしい障壁はない状態にあると思います。 2は、TeX芸人たちをはじめ、わたしの観測範囲にはTeXまわりの技術を楽しんでいる人が何人かいます。 というわけで、あとは3です。 思いつく成功事例としてはMathJaxとかLuaTeXとかありますが、プレゼンでも最後に触れているEPUB対応とか、ほかにもまだ難題は残ってるような気がします。

以上、「気がする」とか「思います」とかが多い記事ですが、それだけTeXの周りにいる人たちが多彩なので一つの見方で断定できないということなのです。そういう方々と交流できる「TeXユーザーの集い」は、今年も自分にとってとても得がたい場でした。

2012/10/20

ロハン・デ・サラム&児玉桃 デュオリサイタル2012に行ってきた

2012年10月19日、ロハン・デ・サラムと児玉桃の共演が津田ホールでありました。 これがロハンおじさん。

このロハンおじさん、アルディッティという人が組織している現代音楽しかやらない弦楽カルテットで長らくチェロをやってきたので、とにかくうまい。 超絶技巧な現代のチェロ曲をさらっと弾く。ヘリコプターの上とかでも平然と弾く。歌うような演奏とは対極にある、クールなうまさです。 十八番はコダーイの無伴奏で、上の写真もロハンおじさんのコダーイが聞ける唯一のCDのジャケットです(ほかにあったら教えてください)。 わりと入手困難で(MP3ならamazonでも買える)、会場の物販にも並んでたやつもロハンおじさんが自ら持ち込んだものだったらしい!

一方の児玉桃も、現代曲、とくにメシアンのCDで名前が知られてるといっても自分的には過言ではないような気がします。 そんなロハン・デ・サラムと児玉桃の共演です。 なんてったってロハン・デ・サラムと児玉桃です! もしかして「イエスの永遠性への賛歌」が生で聴けるのか!って期待するじゃないですか。 百歩譲ってドビュッシーでもいいよ!って思うじゃないですか(2008年のサラムと高橋アキのドビュッシーはよかった)。

違いました。なぜか1曲目はシューマン。なんでロマン派。 シューマンももちろん悪くはないんけど、なにもロハン・デ・サラムと児玉桃でやらなくてもいいのになー。 マイスキーとアルゲリッチとかに任せとけばいいじゃないか。 案の上というか何というか、ロハンおじさんは軽く引き流してるし、どうもミスも多い感じ。 児玉桃のほうは安定してました。ときどき振り返って投げかける「しっかり!ロハン」という視線もぐっときます。

しかし、その次の細川俊夫「チェロとピアノのためのリート」で空気が変わりました。 打って変わって精彩な演奏に、という感じではなく、最初こそちょっぴり1曲目を引きずっていましたが、 児玉桃に引っ張られつつ空気が変わっていく。 続くカーターの「フィグメント」はロハンおじさんのソロだったのですが、すっかり安心して聴けました。

細川俊夫とかカーターとか、後の演目にあるクセナキスとかもそうなのだけど、 自宅でCDを聞いてるだけだと悪い意味で耳に障ることもあるくらいなのに、 こうやってライブを目の当たりにして聴くと形ある音楽が見えてくる。 CDでも、聴く回数を重ねていくとそのうち音楽として聞こえてくるようになるんだけど、 ライブだと、一聴で雑音に見えるものから構造が見えてくるという体験がリアルタイムでできる。 そして、そういう体験をさせてくれるロハンおじさんみたいな現代曲の演奏家は本当にすばらしいと思います。

次のフォーレはよく憶えていない、というか、休憩を挟んだその次のクセナキスの印象が強烈すぎて忘れました。 曲目はコトスで、過去にロハンおじさんの生演奏を聞いたこともあるし、 CD(やはりロハンおじさん演奏)を通じて慣れ親しんでいた曲なので、 個人的に今回のプログラムの中でいちばん楽しみだったわけですが、 なんど見てもカッコいい! まずステージの光景からしてかっこいい。 フレーム構造の譜面台に乗せた黄ばんだ大きめの一枚つづりの楽譜が、ステージの照明で透けて、譜面の密度が客席からも垣間見える。 その向こうでロハンおじさんが一人、あのコトスのしょっぱなの地の底みたいな音の塊を、まるで基礎練習でも始めるみたいにしれっと弾き出す。 なんかテンポもCDより速い気が。中盤になると思わず縦に身体が動いてしまう。クセナキスなのに。 その次のR.シュトラウスもまあ楽しかったですが、ほとんどコトスの余韻だけで楽しんだ気分です。 アンコールはカサドが編曲したグラナドスの何かだといってました。初めて聴く曲だったけど、調べてみると「ゴイェスカス」かな。最後までメシアンを期待してたので残念でしたが、まあ、これはこれでよかったです。

演奏会後にはCD購入者向けのサイン会がありました。 売っていたロハンおじさんのCDはほとんど持っていたので、「インドの作曲家による2曲」(ロハンおじさん談)という、見たこともないCDを買ってサインしてもらいました。 軽く舞い上がってしまい、コダーイ持ってるよとか、どうでもいい話をしてしまいました。 冷静になって思い返したら、松村貞三の17絃箏のための祈祷歌のチェロ独奏版を録音してくれとかせがんでくればよかった。

2012/07/16

DP2 Merrillをもって散歩するのが楽しすぎる件

連休も終わってしまうので、昨日に引き続きSigma DP2 Merrillのレビューっぽいことをしておきます。色の不具合とか質感すげーという話は昨日したので、今日は個人的につぼったポイントを紹介します。

まず画角について。35mmカメラ換算で約45mmという、いわゆる標準レンズの画角なのですが、これがやっぱり使いやすいです。最近はD90+カラースコパー20mmという変態構成で散歩することが多くて、これはこれでボーっと眺めてる景色を四角い画面に収めたいときには都合よくて楽しいのですが、意識的に「何か」を眺めてるときの光景を切り出すのにちょうどいいのは、やっぱり標準レンズだったんだなーと思い出してきました。

10数年前、お金ない学生のころはフィルムカメラに標準レンズをつけて歩くしかなかったわけですが、そのころの感覚もこんなでした。そんなおっさんがDP2 Merrillを使うと、当時の自分には切り取れなかったような光景が切れるんだから、楽しくないわけがないです。

SDIM0127

SDIM0143

SDIM0025

SDIM0055

コンデジっぽくない操作性も評価したい点です。いちばんアクセスしやすい位置に取り付けられているジョグダイヤルには、撮影時には露出とシャッタースピードを変更する機能が割り当てられています。これ、すごく使いやすい。さらに、ホワイトバランスの変更、ISOの変更、MFへの切り替え、露出補正、AEロックといった、個人的に「必須」な操作へのアクセスがおそろしく簡便です。スチル写真を撮る人向けに特化した潔い設計で好感度高いし、実際、直感的な操作体系になるようまとめられてるなあと感じます。

コンデジっぽくないといえば、49mm径のフィルターが装着できるのもポイント高いです。ペンタックスSMCタクマーの標準で利用してたフィルターが軒並み使えるので大興奮です。まあでも、PLフィルターの効果を液晶ファインダーで確認するとか、あんまり正気の沙汰ではない感じもしますが、こまけえこたーどうでもいいんだよ。

DP2 Merrill with PL filter

最後にまたノスタルジックな話。DP2 Merrillで撮影後、Sigma Photo Proでの現像が楽しすぎるのですが、これもやっぱりフィルムの現像と暗室作業をしていたころを思い出します。フィルムの場合、現像と焼付けの時点ではじめて撮影時の妄想が形になるわけですが、DP2 Merrillで撮影したデータもPCで現像していると液晶ファインダーのプレビューでは気がつかなかったような絵が出てくることがあって、これって暗室で印画紙に絵が浮き上がってくる感覚に似てます。もっとも、DP2 Merrillの液晶ファインダーは正直なところ「撮ってすぐ細部を確認」のような使い方をするにはストレスフルなので、それで現像時の驚きが増えてるだけかもしれません。とはいえ、DP2 Merrillで撮影した写真の現像作業は楽しすぎて時間泥棒なのは事実です。

SDIM0128

SDIM0136

SDIM0137

SDIM0027

2012/07/15

Sigma DP2 Merrillがきた

Sigma DP2 Merrill を手に入れました。2月の発表と同時に酒を控えるなどしてこつこつ資金を捻出してきたおかげで発売当日にヨドバシカメラで購入することができました。発売日がちょうど夏休中だったのも幸いでした。日ごろの行いがよかったに違いありません。

さっそく、ヨドバシカメラ秋葉原店の前にあるスターバックスで試し撮りです。

DP2 Merrill

なんか暗いのはスタバの店内だからですが、右側のコーナーが緑がかってるのはなぜだろう。このflickr上の写真はカメラ内現像したJPEGデータですが、X3F形式のデータをIrfanViewで閲覧しても、SIGMA Photo Pro 5で処理しても、やはり緑がかってしまいます。ちょっと気になります。

この四隅が緑がかる現象は、こんな白バックの写真で現れるようです。これを見ると、四隅が緑というだけでなく、白バックの中心も赤みがかりますね。

FM-2 WILDCAT 1/144 Sweet

色について気になるポイントが実はもうひとつあって、それは紫のノイズが出ることです。この写真の二階中央部分に、目立たないですが紫の帯が出現してます。

SDIM0038

露出をアンダーにして現像し、等倍で切り出したのがこちら。

SDIM0038-1-close

この紫ノイズは、SPPで「X3 Fill Light」というパラメータを引き上げて遊んでいるときに初めて気がついたので、そもそもこんなむちゃくちゃな光加減で写真を撮ろうと思わなければいいだけの話ですが、白バックが緑がかるのは撮影時にちょっと警戒しないといけなそう。

難癖は以上でおしまい。実際のところ、このカメラを持って散歩に出かけるのは最高に楽しいです。

まず、とにかくディテールがすごいと噂のFoveonなわけですが、確かにすごいです。意味もなく芝生の写真とか撮りたくなります。

SDIM0044

あと、質感が気持ち悪いくらいすごい。パンケーキの上で溶けかけのバターとか、

SDIM0037

科学博物館の鯨のひれのぬめっとした感じとか、

SDIM0047

オオムラサキの羽の粉っぽさとか。

オオムラサキ

ただしAFでのピント合わせは遅いです。それもあって、オオムラサキはシャッタースピード稼ぐために被写界深度を浅めにしか設定できず、いまいちピントあってないです。とはいえ、フォーカスをいつでもマニュアルへと一瞬で変更できるので、こういうシビアな局面でなくてAFだとおっつかない場合には地味にうれしいです。うどん屋でテーブル上の透明なオブジェ越しに落ち着きのない子どもを撮影とか、AFでどうやって撮るんだという。

SDIM0085

あとノイズについてですが、結論からいうと気にしなくていいと思います。FoveonはノイズがひどいのでISOを上げられないという噂を聞いてたので、けっこう警戒しながら撮影してたのですが、かなり暗い場面で動きのある被写体をディテールは気にしないから雰囲気だけ切り取りたいという気分だったので、思い切ってISO6400に設定し、距離を頼りにMFでシャッターを押してみました。その場で液晶ディスプレイのプレビューを見たときは、盛大なノイズに苦笑いしたのですが、うちに帰ってSPPに読み込ませたら、ほとんどノイズなんて目立たなくなりました。こういう写真を気軽に撮れるのは本当にうれしい。

SDIM0091

あと、カタログに「撮影時には気がつかなかったようなものさえ撮れている」とか何とか書いてあった気がするのですが、本当でした。たまたま撮った風景写真に知り合いが写りこんでるのを自宅に帰ってからPC上で眺めていて発見してしまうくらい。それだけ解像度はすごいです。

2012/07/06

時系列データのグラフをjQueryとFlotで描く

JSONの時系列データがたくさん手に入りました。なにせJSONなんだし、JavaScriptを使ってブラウザにインタラクティブなグラフを簡単に描けそうな気がします。そこでとりあえず折れ線チャートを描くことにしました。むかしjQuery用のFlotというライブラリを使ったことがあったので、今回もこれを使おうと思ったのですが、完全に使い方を忘れていた!そういえば、むかし使ったときも、API.txtという英文がだらだら書かれたテキストファイルしかドキュメントがなくて面倒だったのを忘れていました。そこで今回は備忘録を残しておくことにしたしだい。

なお、Flotはべつに時系列の折れ線チャートを描くためのライブラリではないので、ほかにもいろいろなチャートが描けるはずですが、とくに調べていないので知りません。あくまでも時系列データの折れ線チャートを描くことが目標の備忘録です。

下準備

描画したい時系列データは、こんな1つの配列として用意します。

mydata = [[1309446000000, 6],
          [1312124400000, 9],
          [1314802800000,18],
          [1317394800000,23],
          [1320073200000,27],
          [1322665200000,27],
          [1325343600000,31],
          [1328022000000,35],
          [1330527600000,38],
          [1333206000000,44],
          [1335798000000,49],
          [1338476400000,50]]

要素である長さ2の配列が、それぞれ [日時, データ値] を表しています。

第一要素の日時が 1309446000000 のようなでっかい数値なのは、UNIX時間をミリ秒単位で表したものだからです。これ以外の書式でFlotに日時を指定するすべはありません。もし「2012年7月4日の値は12で、2012年7月5日の値は0で、……」だったら、 [[1341327600000, 12], [1341414000000, 0], ...] という配列を用意するわけです。Gaucheで用意するならこんな感じ。( construct-json-string は、S式からJSON表記の文字列をよろしく作ってくれる関数です。)

(use srfi-19)
(use gauche.sequence)
(use rfc.json)
(define (localtime->jstime str)
  (* 1000
     (time->seconds
      (date->time-utc
       (string->date str "~Y年~m月~d日")))))

(define mydata
  #(#("2012年7月4日" 12) #("2012年7月5日" 0)))

;; (construct-json-string mydata) の出力ではだめ

(construct-json-string
 (map-to <vector>
         (lambda (v) (vector (localtime->jstime (ref v 0)) (ref v 1)))
         mydata))

ちなみに、日時に限らず、Flotが受け付けてくれる値データは数値のみです。文字列の値データは与えないこと。

とりあえず描く

おおざっぱなノリとしては、HTMLページ中にグラフの出力場所を作っておいて、 jQuery.plot(出力場所, [データ列], オプション) とすれば、それっぽい折れ線チャートができるという仕組みです。

<html>
<head>
  <script language="javascript" type="text/javascript"
    src="http://code.jquery.com/jquery-latest.js"></script>
  <script language="javascript" type="text/javascript"
    src="flot/jquery.flot.js"></script>
</head>
<body>
  <div id="placeholder" style="width:600px;height:300px;"></div>
</div>
<script>
var options = { xaxis : 
                 { mode : "time"}
              };
var mydata = [
              [1309446000000, 6],
              [1312124400000, 9],
              [1314802800000,18],
              [1317394800000,23],
              [1320073200000,27],
              [1322665200000,27],
              [1325343600000,31],
              [1328022000000,35],
              [1330527600000,38],
              [1333206000000,44],
              [1335798000000,49],
              [1338476400000,50]
             ];
$.plot($("#placeholder"), [mydata], options);
</script>
</body>
</html>

描画する場所は、この例では <div id="placeholder" style="width:600px;height:300px;"></div> です。このように、必ず縦と横の長さを明示してやります。

スクリプトから、この描画場所を参照するときは、この例のようにセレクタを jQuery() に渡してjQueryオブジェクトを作り、それを渡します。グラフを表示するだけなら、 $.plot("div#placeholder",...) のようにセレクタを直接指定するだけでもかまわないようですが、あとでjQueryオブジェクトの bind() メソッドを使ってインタラクティブな機能を付け足したいので、jQueryオブジェクトにしておきます。

$.plot() の3つ目の引数である options は、上記の例では {xaxis : { mode : "time"}} です。「x軸( xaxis )のデータの種類( mode )は日時( "time" )だよ」と意味です。こう指定すれば、元データの第一要素が日時データとして解釈され、x軸にそれっぽいラベルが適当な間隔でふられます。描画の際のオプションはほかにもいろいろ指定できますが、時系列データをプロットするときによく使いそうなものだけメモしておきます。ほかは公式のテキストで「Customizing the axes」とか検索して調べる。

項目オプション値の例意味
xaxismode"time"x軸の値を日時とみなす。
timeformat"%y/<br>%m"日時ラベルの書式。htmlタグ使える。
ticks10x軸に表示するラベルの数。画面に入らないと適当にふり直してくれる。
[]x軸にラベルを表示しない。
tickSize[1, "day"]1日おきにラベルをふる。
gridclickabletrueグラフをクリックしてイベント飛ばせるようになる。
hoverabletrueグラフにマウスオーバーでイベント飛ばせるようになる。

あらかじめ用意するデータ列 mydata はそもそも配列ですが、それをさらに [mydata] のように配列で括ってから $.plot() に渡している点に注意。この配列に複数のデータ列 [mydata1, mydata2] を指定すれば、ひとつのチャートに複数の折れ線を重ねてプロットできます。

var mydata1 = [
               [1309446000000, 6],
               [1312124400000, 9],
                ...                // 長いので省略
              ];
var mydata1 = [
               [1309446000000, 0],
               [1312124400000, 10],
                ...                // 長いので省略
              ];
$.plot($("#placeholder"), [mydata1, mydata2], options);

さて、この例のように $.plot() に引数として描画の際のオプションを渡すのでは、それぞれの線の色を好みに応じて変えたり凡例を指定したりすることはできません。次はその方法です。

凝ったグラフ用にデータを準備する

ここまでの例では、jQuery.plot()の第二引数に、 [[日時,データ], ...] というカタチをしたデータ列そのものを指定してました。実はこれは手抜きなやり方で、本当はデータ列とそのメタ情報をJavaScriptのオブジェクトとしてまとめて指定します。

var myseriese1 = {
                   label : "rapid",                   // データ列の名前
                   data  : mydata1,                   // データ列
                   color : "rgba(255, 0, 0, 0.8)",    // チャートの色
                   ...                   // ほかはドキュメント参照
                 }

var myseriese2 = {
                   label : "human",                    // データ列の名前
                   data  : mydata2,                    // データ列
                   color : "#rgba(255, 0, 0, 0.8)".    // チャートの色
                   ... 
                 }
$.plot($("#placeholder"),
       [myseriese1, myseriese2],
       $.extend(true, {}, options, { legend : { position : "nw" }}));

color は、まあ、線の色です。 label のほうは、指定した文字列が凡例に使われます。凡例は、デフォルトではグラフ領域の右上に表示されますが、これを左上に移動したいときは、この例のようにしてオブジェクト options を拡張( jQuery.extend() )してやります。 "nw" は「北西」ですね。

外部のファイルからJSONデータを読み込む

Flotがデータ列としてとるオブジェクトは、見ての通りまんまJSONです。そこで外部のファイルに保存してあるJSONのデータを読み出してグラフにしたい。これにはjQueryの jQuery.getJSON() メソッドを使います。

JSONがFlotのデータ列として適当な形式になってるとは限らないので、たとえばこんな内容のファイル mydata.json があったとしましょう。

[{
   "entry" : {
               "code"  : "rapid",
               "title" : "うさぎ",
               "data"  : [[1309446000000, 6],
                          ...                    // 省略
                          [1338476400000,50]]
             }
 },
 {
   "entry" : {
               "code"  : "human",
               "title" : "ヒト",
               "data"  : [[1309446000000, 6],
                          ...                    // 省略
                          [1338476400000, 1]]
             }
 },
 ... // 省略
]

"data" をデータ列として使い、 "title" を凡例用のラベルとして使い、チャートを書きたいとします。

var options = { xaxis: { mode: "time" },
                legend : { position : "nw" }
};

$.getJSON("mydata.json", function (json) {
  var target1 = getEntry(json, "rapid");
  var target2 = getEntry(json, "human");

  var plotdata = [{label : target1.title , data : target1.data},
                  {label : target2.title , data : target2.data}];

  $.plot($("#placeholder"), plotdata, options);
});

function getEntry (json, codestr) {
  i=0;
  while (i < json.length) {
    if (json[i].entry.code == codestr) {
      return json[i].entry}
    ++i}
  return false;
};

出力は前の例とほとんど一緒なので省略。

インタラクティブなグラフにしたい

いままでの要領でまず素朴なグラフを描き、その描画領域のjQueryオブジェクト(いまの例では $("#placeholder") )の bind() メソッドを使うことで、グラフにさまざまな機能を付け足すことができます。たとえば、上の例で $.getJSON() に渡している関数の中身に以下のコードを付け足すことで、「グラフ上をマウスでドラッグした範囲にズーム」という芸当ができるようになります( jquery.flot.selection.js が必要なのでHTMLファイルのヘッダ部分に呼び出しを追加しておくこと)。

  $("#placeholder").bind("plotselected", function (event, ranges) {
      $.plot($("#placeholder"), plotdata,
             $.extend(true, {}, options, {
                 xaxis: { min: ranges.xaxis.from, max: ranges.xaxis.to }
             }));
  });

bind の第一引数に指定できるイベントには、この例で使った "plotselected" のほか、 "plothover" や "plotclick" などがあります。名前のとおり、選択した領域に対するアクション、マウスオーバー時のアクション、マウスクリック時のアクションを関数として指定できます。ほかにもありそうだけど調べてません。このへんはドキュメントにはあまり解説がなくて、むしろ公式サンプルで遊びながらソースを参照しましょう。下の画面程度の完成度でよければ、サンプルからのコピペ駆動でそれほど苦もなく実現できます。
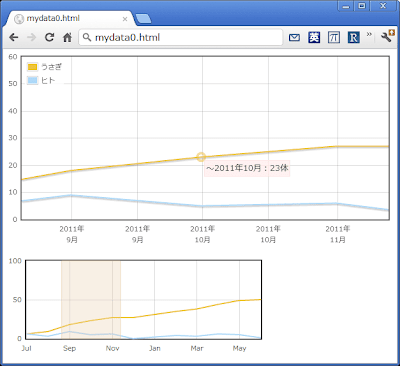
<html>
<head>
  <script language="javascript" type="text/javascript"
    src="http://code.jquery.com/jquery-latest.js"></script>
  <script language="javascript" type="text/javascript"
    src="flot/jquery.flot.js"></script>
  <script language="javascript" type="text/javascript"
    src="./flot/jquery.flot.selection.js"></script>
</head>
<body><div>
  <div id="placeholder" style="width:600px;height:300px;"></div>
  <br>
  <div id="overview" style="width:400px;height:150px"></div>
</div>
<script>
var options = { xaxis: { mode: "time", timeformat: "%y年<br>%m月"},
                legend : { position : "nw" },
                selection: { mode: "x" },
                grid: { hoverable: true, clickable: true }
};

$.getJSON("mydata.json", function(json) {
  var target1 = getEntry(json, "rapid");
  var target2 = getEntry(json, "human");

  var plotdata = [{label: target1.title , data: target1.data},
                  {label: target2.title , data: target2.data}];

  var plot = $.plot($("#placeholder"), plotdata, options);

  var overview = $.plot($("#overview"), plotdata, {
      series: {
          shadowSize: 0
      },
      legend: { show: false },
      xaxis: { mode: "time" },
      yaxis: { ticks: 1, min: 0, autoscaleMargin: 0.1 },
      selection: { mode: "x" }
  });
  
  var previousPoint = null;
  $("#placeholder").bind("plothover", function (event, pos, item) {
    if (item != null && previousPoint != item.datapoint) {
      previousPoint = item.datapoint;
      $("#tooltip").remove();
      var d = new Date(item.datapoint[0]),
          Y = d.getFullYear(),
          M = d.getMonth() + 1,
          r = item.datapoint[1].toFixed();
      showTooltip(item.pageX, item.pageY,
          "~" + Y + "年" + M + "月" + ":" + r + "体");
    } else {
      $("#tooltip").remove();
      previousPoint = null;
    }
  })
  
  $("#placeholder").bind("plotselected", function (event, ranges) {
    var plot = $.plot($("#placeholder"), plotdata,
                      $.extend(true, {}, options, {
                        xaxis: { min: ranges.xaxis.from, max: ranges.xaxis.to }
                      }));
    overview.setSelection(ranges, true);
  });
  $("#overview").bind("plotselected", function (event, ranges) {
    plot.setSelection(ranges);
  });
});

function getEntry (json, codestr) {
  var i=0;
  while (i < json.length) {
    if (json[i].entry.code == codestr) {
      return json[i].entry}
    ++i}
  return false;
};

function showTooltip(x, y, contents) {
  $('<div id="tooltip">' + contents + '</div>').css( {
    position: 'absolute',
    display: 'none',
    top: y + 5,
    left: x + 5,
    border: '1px solid #fdd', 
    padding: '2px',
    'background-color': '#fee',
    opacity: 0.80
  }).appendTo("body").fadeIn(200);
};

</script>
</body>
</html>

2012/01/13

n進数で文字列探索

4桁の整数のなかで「42」という並びを含むものを探すことを考えます(10進で考えます)。 こんな二階建ての再帰でいけそうです。

『「末尾が42の数を全部集める」』→
『「末尾が420の数を全部集める」→「末尾が421の数を全部集める」→…→「末尾が429の数を全部集める」』→
『「末尾が4200の数を全部集める」→…』

『…』の再帰は、こんな感じ。

(define (migi base hidari)
  (iota (expt 10 base) hidari))

「42」が出現してる場所より右側をなめるので、migi という名前にしました。 引数の hidari には「42なんとか」(なんとかは空か数字の列)が順番に入る、という気持ちです。 base が 0 なら「42」、base が 1 なら「420から429」、base が 2なら「4200から4299」、…という具合。「42なんとか」を始点に、10 の base 乗個とってくればよいので、iota を使っています。

「…」の再帰については、migi を受けて hidari の全パターンを集めるので、こんな unfold で書けます。

(define (hidari-all upper order)
  (lambda (migi)
    (unfold (pa$ < upper) values
            (pa$ + (expt 10 order))
            migi)))

ようするに、 migi が「42」の場合には「xx42」の xx にあらゆる数字の組み合わせをぶちこんだリストです。migi が「420から429」なら「0420, ..., 9420, 0421, ..., 9421, ..., 0429, ..., 9429」で、migi が「4200から4299」ならそのものです。 migi の要素が2桁である「42」のときは10の2乗( = 100)を次々に加えていったもの全部、3桁である「420から429」のときは10の3乗( = 1000)をそれぞれに次々加えていったもの全部、…という具合です。これらを unfold で作り出しています。

以上の2つの再帰を組み合わせれば完成です。(hidari-all の order を決めるときにちょっと苦心しました。)

(define (intseek order num)
  (let1 upper (+ 1 (expt 10 order)) ; 9999 + 1
    (let R ((b 0) (hidari num))
      (if (> b (- order (ord num)))
          '()
          (append
            (append-map (hidari-all upper (+ b (ord num))) (migi b hidari))
            (R (+ b 1) (* hidari 10)))))))

; 最近のGaucheなら(log x 10)で済むのだけど。
(define (ord x)
  (x->integer (/ (log x) (log 10))))
結果はこうなります(途中は省略)。
gosh> (intseek 4 42)
(42 142 242 342 442 542 642 742 842 942 1042 1142 ... 4295 4296 4297 4298 4299)

この遊び、なにも10進に限る必要はありません。2進表記で10桁の整数から「11」の並びを含むものを探すとか、16進表記で4桁の整数から「aa」の並びを含むものを探すとか、簡単に応用できます。

(define (intseek order str radix max-digit)
  (define (hidari-all upper order)
    (lambda (migi)
      (unfold (pa$ < upper) values
              (pa$ + (expt radix order))
              migi)))
  (define (migi b hidari)
    (iota (expt radix b) hidari))
  (let1 upper ; radix進でorder桁の最大数 + 1
      (+ 1 (string->number (make-string order max-digit) radix))
    (let R ((b 0) (hidari (string->number str radix)))
      (if (> b (- order (string-length str)))
          '()
          (append
            (append-map (hidari-all upper (+ b (string-length str)))
                        (migi b hidari))
            (R (+ b 1) (* hidari radix)))))))
gosh> (map (cut format "~x" <>) (intseek 4 "aa" 16 #\F))
("aa" "1aa" "2aa" "3aa" "4aa" "5aa" "6aa" "7aa" ... "aafd" "aafe" "aaff")

さらに、26進の数字で特定の並びを含むものを探すこともできるはずです。ということは、26進の数字とアルファベット26文字を対応させてやれば、n文字のアルファベット文字列から特定の文字の並びを含むものを見つける、といった問題にも応用できることになります。さすがに26進だと表記につかう26個の文字を扱うのつらいのでやる気になりませんが、次の問題くらいなら4進で済むので、この方法を使って解けそうです。

4種類のアルファベット "A,C,G,T" から成るn文字の文字列のうち、"AAG"という並びが含まれる文字列を全て列挙するプログラムを書きなさい。ただし、nは3以上の整数とし、文字列内に同じアルファベットが出現しても構わないものとし、出力順序は問わないものとします。 ... 適性検査に合格された方はその生産性を実現可能な方です。生産性に見合う初任給として年俸1000万円をご用意しております。
(via: 名古屋Scala掲示板 年俸1000万の会社の試験問題)

アルファベットと4進数との変換だけ定義してやれば、1000万ゲット。

(define mapping
  '((#\A #\3) (#\C #\2) (#\G #\1) (#\T #\0)))

(define (acgts n ls)
  (map (lambda (int)
         (ints->acgt (string-pad (number->string int 4) n #\0)))
       ls))

(define (acgt->ints str)
  (string-map (lambda (c) (cadr (assoc c mapping))) str))

(define (ints->acgt str)
  (string-map (lambda (c) (cadr (assoc c (map reverse mapping)))) str))
gosh> (acgts 5 (intseek 5 (acgt->ints "AAG") 4 #\3))
("TTAAG" "TGAAG" "TCAAG" "TAAAG" "GTAAG" "GGAAG" "GCAAG" "GAAAG" "CTAAG"
 "CGAAG" "CCAAG" "CAAAG" "ATAAG" "AGAAG" "ACAAG" "AAAAG" "TAAGT" "GAAGT"
 "CAAGT" "AAAGT" "TAAGG" "GAAGG" "CAAGG" "AAAGG" "TAAGC" "GAAGC" "CAAGC"
 "AAAGC" "TAAGA" "GAAGA" "CAAGA" "AAAGA" "AAGTT" "AAGTG" "AAGTC" "AAGTA"
 "AAGGT" "AAGGG" "AAGGC" "AAGGA" "AAGCT" "AAGCG" "AAGCC" "AAGCA" "AAGAT"
 "AAGAG" "AAGAC" "AAGAA")

2012/01/06

一筆書きドラゴン曲線

TeX でドラゴン曲線を描こうと思ったのですが、クヌース先生がとっくにやってしまっていて、あろうことか『TeXブック』にまで載せていました。出力結果は『TeXブック』に載っていないので、とりあえず写経して pdftex にかけてみたら、確かにきれいな龍が現れました。

そのクヌース先生のコードですが、実際にドラゴン曲線を描くコードはたったの 2行です。

\def\dragon{\ifnum\n>0{\advance\n-1 \dragon\L\nogard}\fi}
\def\nogard{\ifnum\n>0{\advance\n-1 \dragon\R\nogard}\fi}

どうやら相互再帰みたいですね。 Scheme で書くならこんな感じでしょうか。

(define (dragon-curve dim)
  (define (dragon i)
    (if (> i 0)
        (append (dragon (- i 1)) 
                turn-left
                (nogard (- i 1)))
        '()))
  (define (nogard i)
    (if (> i 0)
        (append (dragon (- i 1))
                turn-right
                (nogard (- i 1)))
        '()))
  (dragon dim))

ドラゴン曲線は、「線分を真ん中で直角に折る」という操作を、折り曲げてできた 2つの線分に繰り返し適用して得られる自己相似なフラクタル図形です。ただし、折り曲げてできた 2つの線分を再び折り曲げる際には、それぞれ違う向きに操作を適用します。最初の線分の向きが「→→」だとしたら、「→←」という具合に、折り曲げてできた 2つの線分の双方に対して逆向きに繰り返し操作を適用するわけです。

で、クヌース先生はこれをうまく利用することで、\dragon と \nogard (dragon を逆から読んだ)を相互再帰させているわけですね。それぞれの真ん中にある \L と \R は曲げる方向で、結果として \dragon は \L と \R からなる列に展開されます。この \L と \R にしたがって頭から進んでいけば、一筆書きの要領でドラゴン曲線が得られるという寸法です。

TeXもいいですが、一筆書きといったら『関数プログラミング』(R. バード,P.ワドラー著/武市 正人訳)の亀の子図形でしょう。むかし書いた Scheme 版でドラゴン曲線をやってみます。切り貼りして説明書くの面倒くさくなったのでファイルまるごと掲載。

;;;; dragon.scm
(use srfi-1)
(use srfi-42)
(use util.match)

;; state -> state
(define (move state)
  (match state
    (`((,x ,y) 0) (make-state (- x 1) y 0))    ;; N
    (`((,x ,y) 1) (make-state x (- y 1) 1))    ;; W
    (`((,x ,y) 2) (make-state (+ x 1) y 2))    ;; S
    (`((,x ,y) 3) (make-state x (+ y 1) 3))    ;; E
    ))

(define-syntax let-state
  (syntax-rules ()
    ((_ e1 (e2 e3 e4) e5 ...)
     (let ((e2 (caar e1))
           (e3 (cadar e1))
           (e4 (cadr e1)))
       e5 ...))))

;; state -> state
(define (turn-left state)
  (let-state state
      (x y d)
    (make-state x y (remainder (+ d 1) 4))))

;; state -> state
(define (turn-right state)
  (let-state state
      (x y d)
    (make-state x y (remainder (+ d 3) 4))))

;; state
(define (make-state x y d)
  (list (list x y) d))

;; state -> [state -> state] -> [state]
(define (scanf init procs)
  (if (null? procs)
      '()
      (let ((value ((car procs) init)))
        (cons value
              (scanf value (cdr procs))))))

;; draw as ASCII art

;; [state] -> [[boole]]
(define (to-bitmap ps)
  (define (range xs)
    (list-ec (: i (apply min xs) (+ (apply max xs) 1)) i))
  (define (orlist ls)
    (cond ((null? ls) #f)
          ((car ls) #t)
          (else
           (orlist (cdr ls)))))
  (define (in? x xs)
    (orlist (map (cut equal? <> x) xs)))
  (let ((codes (map car ps)))
    (list-ec (: x (range (map car codes)))
             (list-ec (: y (range (map cadr codes)))
                      (in? (list x y) codes)))))

;; [[boole]] -> string
(define (draw bitmap)
  (string-join
   (map (lambda (y)
          (string-join (map (lambda (x) (if x "#" " ")) y)
                       "" 'strict-infix))
        bitmap)
   "\n" 'strict-infix))

(define (dragon-curve dim)
  (define (dragon i)
    (if (> i 0)
        (append (nogard (- i 1))
                (list move turn-left)
                (dragon (- i 1)))
        '()))
  (define (nogard i)
    (if (> i 0)
        (append (nogard (- i 1))
                (list move turn-right)
                (dragon (- i 1)))
        '()))
  (scanf (make-state 0 0 0) (dragon dim)))

(define (main args)
  (print
   (draw
    (to-bitmap
     (dragon-curve (x->integer (cadr args))))))
  0)
$ gosh dragon.scm 8
     ####    ####       
    #####   #####       
    ####### #######     
      #####   #####     
 #################      
#################       
###### ### ########     
  ####  ## ########     
 ###       #######      
####       ######    ## 
####  #    ### ####   ##
  #####     ## ####   ##
  ####         #########
               #########
               ### ###  
                ##  ##  

なんかひっくり返ってますが、無事にドラゴン出ました。