2010/09/11

TeXのトイ実装で数式をHTML表示する話


What TeX-modoki is


TeX-modoki is aiming to become a subset of plain TeX implementation. Instead of DVI or PDF, it is intended to generate a plain-old HTML file. Being fully compliant with TeX's macro language, it could support LaTeX or other packages. I wish all the legacy TeX manuscripts around the world someday became readable on any web browser.

TeX-modoki は plain TeX の簡易実装です。出力はDVIやPDFではなくHTMLです。TeXのマクロ言語を実装しているので、LaTeXのような一般的なパッケージを使って書かれた原稿にも原理的には対応できるはず。地球上のあらゆる既存のTeX原稿がブラウザで文字データとして閲覧できるようになればいいな。

Sample Output


For now, you get some mathematical formula in HTML/CSS2.1 from a plain TeX source, though the output needs further refinement.

現状の出力機能はやっつけだけれども、HTML/CSSなので、たいていのブラウザでそれっぽく数式を表示できるようにはなっている。

1. Simple example


Displaying fraction or choice is trivial for TeX but for HTML.

分数など。

(tokenlist->html
(output
(string->tokenlist
"$_nC_{k/2} = {n\\atopwithdelims() {k\\over 2}}$")))


The result is
 
n


C
 
k
 
 
/
 
 
2


 = ( 
n


k


2


 ) 


2. Example with mathematical symbols


Mathematical symbols can be defined in the same way as plain TeX, except you must specify them with Unicode but TeX's character encoding. You can also compose any original symbol in the TeX manner. In this example, \cdots is defined exactly the same way as the Appendix B of "The TeXbook."

数式で使う記号類は、TeXとまったく同じ方法で、TeXの文字コードの代わりにUnicodeの値を指定しておきます。独自に合成した記号も、やはりTeXと同じようにして定義できます。(実際、以下の例の \cdots は「TeXブック」付録Bの定義そのままです。)

(tokenlist->html
(output
(string->tokenlist
"\\mathchardef\\infty = \"0221e \\mathchardef\\sum = \"103a3 \\mathchardef\\cdotp = \"000b7\
\\def\\cdots{\\mathinner{\\cdotp\\cdotp\\cdotp}}\
The exponential function
$e^x = \\sum_{n=0}^{\\infty} {x^n \\over n!}
= {x^1\\over 1!} + {x^2\\over 2!}+ \\cdots$ . ")))


The result is

The exponential function e
x


 = 


Σ
n
 
 
 = 0


x
n


n
 
 
!


 =  
x
1


1
 
 
!


 +  
x
2


2
 
 
!


 + ·
 
 
·
 
 
·


  .


3. Square-root


Square root is hard to display neatly in HTML/CSS without font-stretch. It’s decent if the inner elements fit in a line.

根号は、CSS2.1ではフォントを上下に伸ばせないので、なかなかきれいには表示できません。中身が一行なら、そこそこの見た目にはなります。


(tokenlist->html
(output
(string->tokenlist
"\\def\\sqrt{\\radical\"2221a}
\\mathchardef\\plusminus=\"300b1
Roots of a quadratic equation $ax^2+bx+c=0$ are
$x={-b\\plusminus\\sqrt{b^2 - 4ac} \\over 2a}$.")))


The result is

Roots of a quadratic equation ax
2


 + b
 
 
x
 
 
 + c
 
 
 = 0
 
 
  are x
 
 
 =  
 
 
b
 
 
 ±  b
2


  4
 
 
a
 
 
c


2
 
 
a


 .


4. More complicated formula


Integral symbol should be nolimit style.

積分記号の添字は上下ではなく横に付くべきですが、これもTeXの定義のままHTMLで表示できます。

(tokenlist->html
(output
(string->tokenlist
"\\mathchardef\\intop=\"1222b\
\\mathchardef\\infty=\"1221e\
\\mathchardef\\pi=\"003c0\
\\mathchardef\\sigma=\"003c3\
\\mathchardef\\mu=\"003bc\
\\def\\sqrt{\\radical\"2221a}\
\\def\\int{\\intop\\nolimits}\
$\\int_{-\\infty}^\\infty \
{1 \\over \\sqrt{2\\pi\\sigma^2}}\
\\hbox{exp}(- {{(x-\\mu)}^2\\over 2\\sigma^2}) dx$")))


The result is


1


 2
 
 
π
 
 
σ
2


exp
 
 
(


(x
 
 
  μ
 
 
) 
2


2
 
 
σ
2


)d
 
 
x


2010/07/02

SLaTeXを使う。Gaucheで。

SLaTeXをGaucheで使いたい。

SLaTeXは、Schemeのコードを装飾するためのtex->texコンバータ。\scheme|...|とか\begin{schemedisplay}...\end{schemedisplay}といった感じでSchemeのコードを(La)TeXの原稿中に書いておくと、その各部分に装飾を施した一時的なtexファイルをSchemeスクリプトで大量に生成してくれる。それをTeXの処理系に渡すところまでやってくれるslatexというシェルスクリプトがついているので、latex foo.texのかわりにslatex foo.texとすればよい。

よいのだけど、実際に使うとなんとなく微妙。一時ファイルが大量にできるのは気持ちが悪いし、添付のスタイルが(少なくとも日本語環境では)あんまりうまくない。プリティプリンタというわけでもなさそうで、インデントの面倒も見てくれない。

あと、現時点ではそのままGaucheで使えない。とりあえず使えるように、次のようなパッチをあてた。これでgosh /(path to scmxlate)/scmxlate.scmのようにすると、Gauche用のslatex.scmと、platexを使うシェルスクリプトができる。
diff -rupN slatex/dialects/dialects-supported.scm myslatex/dialects/dialects-supported.scm
--- slatex/dialects/dialects-supported.scm 2002-11-24 05:06:34.000000000 +0900
+++ myslatex/dialects/dialects-supported.scm 2010-07-02 16:31:41.000000000 +0900
@@ -1,6 +1,7 @@
bigloo
chez
gambit
+gauche
guile
mitscheme
mzscheme
diff -rupN slatex/dialects/gauche-slatex-src.scm myslatex/dialects/gauche-slatex-src.scm
--- slatex/dialects/gauche-slatex-src.scm 1970-01-01 09:00:00.000000000 +0900
+++ myslatex/dialects/gauche-slatex-src.scm 2010-07-02 18:08:41.000000000 +0900
@@ -0,0 +1,12 @@
+(define getenv sys-getenv)
+
+(define *scheme-version*
+ (string-append "Gauche " (gauche-version)))
+
+(define void
+ (lambda ()
+ (if #f #f)))
+
+(scmxlate-postprocess
+ (define *scheme-command-name* "gosh")
+ (load "./dialects/make-echo-script.scm"))
diff -rupN slatex/dialects/make-echo-script.scm myslatex/dialects/make-echo-script.scm
--- slatex/dialects/make-echo-script.scm 2002-03-25 01:26:22.000000000 +0900
+++ myslatex/dialects/make-echo-script.scm 2010-07-02 17:13:53.000000000 +0900
@@ -3,12 +3,16 @@
(rename-file "my-slatex-src.scm" "slatex.scm")
(delete-file "slatex")
(delete-file "callsla.scm"))
+ ((gauche)
+ (sys-rename "my-slatex-src.scm" "slatex.scm")
+ (if (file-exists? "slatex") (sys-remove "slatex"))
+ (if (file-exists? "callsla.scm") (sys-remove "callsla.scm")))
(else
(system "mv my-slatex-src.scm slatex.scm")
(system "rm -f slatex callsla.scm")))


-(load "dialects/make-callsla.scm")
+(load "./dialects/make-callsla.scm")

(call-with-output-file "slatex"
(lambda (o)
@@ -18,11 +22,7 @@
(display ")" o) (newline o)
(display ";check pathname above is correct for you" o)
(newline o)
- (display "(slatex" o)
- (display (if (eqv? *dialect* 'bigloo)
- "$$"
- "::") o)
- (display "process-main-tex-file \"'$1'\")" o)
+ (display "(process-main-tex-file \"'$1'\")" o)
(if (eqv? *dialect* 'scsh)
(begin
(newline o)
@@ -32,10 +32,11 @@
(newline o)
(display "if test -f pltexchk.jnk" o) (newline o)
(display "then tex $1; rm pltexchk.jnk" o) (newline o)
- (display "else latex $1" o) (newline o)
+ (display "else platex $1" o) (newline o)
(display "fi" o) (newline o)))

(case *dialect*
((scsh) (run (chmod "+x" slatex)))
+ ((gauche) (sys-chmod "slatex" 484))
(else (system "chmod +x slatex")))

diff -rupN slatex/scmxlate-slatex-src.scm myslatex/scmxlate-slatex-src.scm
--- slatex/scmxlate-slatex-src.scm 2009-09-29 08:28:56.000000000 +0900
+++ myslatex/scmxlate-slatex-src.scm 2010-07-02 17:07:17.000000000 +0900
@@ -16,10 +16,10 @@

(scmxlate-eval
;on denali
- ;(define *target-file* "/home/dorai/.www/slatex/slatex.scm")
+ (define *target-file* "/home/kshikano/src/slatex/slatex.scm")

;on mac
- (define *target-file* "/Users/doraisitaram/public_html/slatex/slatex.scm")
+ ;(define *target-file* "/Users/doraisitaram/public_html/slatex/slatex.scm")
)

;You may define slatex::*texinputs* here. Eg,
@@ -30,7 +30,7 @@
;(define slatex::*texinputs*
;"/home/dorai/tex:/usr/local/lib/tex/macros") ;in Unix

-;(define slatex::*texinputs* (getenv "TEXINPUTS"))
+(define slatex::*texinputs* (sys-getenv "TEXINPUTS"))

;Unfortunately, that last one is not really as convenient as
;it seems, even if your Scheme has a getenv procedure.

2010/06/24

The WYSIWYG Conundrum: The Solid Cloud � An American Editor

The WYSIWYG Conundrum: The Solid Cloud � An American Editor:
"Success is much more than the number of downloads of free or 99� ebooks, especially when there is no way to know how many of those downloads actually were read or well thought of. Instead, success is having readers clamor for your books, talk about your books, express a willingness to pay a higher price for your books — all things that a professional editorial eye can help an author achieve by preventing the kinds of mistakes that turn readers away."


「(本の)成功とは、タダだったり100円だったりするebookがたくさんダウンロードされることじゃない。そのうち何冊が読まれたか確かめようがないなら、なおさらだ。成功というのは、そんなことではなく、読者がその本を話題にしてくれて、もっとお金を払いたいと思ってくれることにある。その本を読んだ人をがっかりさせるようなミスを防ぐことにこそ、プロの編集者の役割がある。」

これ以上なにも付け足すことがない。

2010/06/03

Emacs上での正規表現による検索で結果をハイライトしっぱなしにする

たまーに、「emacs」「検索」「ハイライト」で過去のエントリを見てもらっているようなのですが、あれはバグっているのです。バグっているというか、フォントロックの仕組みをちゃんと理解していなかったので、実行するとメジャーモードの色づけを葬ってしまう。

いまは改良してこうなっています。(Emacs 22.2.1)
(defun keep-highlight-regexp (re)
(interactive "sRegexp: \n")
(make-face 'my-highlight-face)
(set-face-foreground 'my-highlight-face "black")
(set-face-background 'my-highlight-face "yellow")
(defvar my-highlight-face 'my-highlight-face)
(setq font-lock-set-defaults nil)
(font-lock-set-defaults)
(font-lock-add-keywords 'nil (list (list re 0 my-highlight-face t)))
(font-lock-fontify-buffer))

(defun cancel-highlight-regexp ()
(interactive)
(setq font-lock-set-defaults nil)
(font-lock-set-defaults)
(font-lock-fontify-buffer))

(global-set-key "\C-f" 'keep-highlight-regexp)
(global-set-key "\C-d" 'cancel-highlight-regexp)
[Ctrl]-[f]で検索開始、[Ctrl]-[d]でハイライト解除。それぞれ、自分では通常のキーバインドとして使ってないので、グローバルに設定しています。

2010/03/26

稼働中のマシンのHDDから、VMware Player用の仮想マシンを作る

稼働中の物理マシンの HDD を、そっくり仮想イメージに変換して、 VMware Player で再生できるようにしたい。手順としてはこれだけなんだけど……
  1. 対象の HDD をダンプする(partimage を使う)
  2. VMware 用の仮想ディスクを空っぽの状態で作る(QEMU を使う)
  3. 2.の空っぽ仮想ディスクに領域を作る(fdisk を使う)
  4. 1.のダンプを、3.の領域へとリストアする(partimage を使う)
それなりに広大な作業スペースが必要だし、個々の作業に時間がかかるので(待ち時間にこんな記事がかけるくらい)、次回以降はできるだけ要領よく済ませたい。だから自分用にメモ。もちろん無保証です。

用意するもの。
  • 作業場
    ここでは Windows マシンを使う。対象の HDD 上で動いてなくて、VMware と QEMU が使えて、でかいディスク容量があるマシンなら、何でもいいと思う。

  • 起動環境
    ここでは Knoppix の iso イメージを使う。VMware 用の仮想イメージ以外で、fdisk と partimage が使える環境を VMware Player から起動できるものなら、何でもいいと思う。

  • QEMU
    空っぽの仮想ディスクを作るのに使う。ここでは QEMU on Windows の qemu-img コマンドを使う。


実際の作業の流れ。
  1. partimage で対象の HDD をダンプして、作業場からファイルとして見える場所にイメージファイル(群)として保管する。

  2. Windows のコマンドプロンプトで、qemu-img コマンドを使って空っぽの VMware 用仮想ディスクを作る。対象の HDD と同じサイズで vmdk 形式にする。対象が 120Gバイトならこんな具合。
    > qemu-img create -f vmdk hokansaki.vmdk 120G
    これでhokansaki.vmdkという仮想ディスクができる。

  3. 空っぽの仮想ディスクをフォーマットしたいのだけど、空っぽなので、当然のことながら VMware Player で仮想マシンを起動することができない。そこで、何かしら起動環境が必要になる。空っぽの物理ディスクに OS をインストールするときと同じ理屈ですね。つまり、BIOSチップ を CD/DVDブートにするのと同じ要領で、VMware Player の BIOS を CD/DVD ブートに設定し、ROM ドライブに Knoppix のディスクを入れて Player を再起動すればいい。VMware Player の起動時に F2 を押せば BIOS 画面に入れる。
    ただ、せっかく仮想マシンなんだから、わざわざ物理的な起動ディスクを使う必要もない。作業場の HDD 上に Knoppix の iso を置いておいて、それを Player の起動時に読むようにしたほうが手っ取り早いというもの。つまり、こんな vmx ファイルで仮想マシンを読み込めばいい。(この例では Windows の Fドライブ以下に Knoppix 5.1.1 の iso が置いてある。guestOS の一覧はこのへんを参考に。ide1 の deviceType を cdrom-image としているため、この場合も BIOS で CD/DVD ブートに設定する必要あり)
    .encoding                = "Shift_JIS"
    config.version = "8"
    virtualHW.version = "4"
    memsize = "512"

    ide0:0.present = "TRUE"
    ide0:0.fileName = "hokansaki.vmdk"
    ide0:0.mode = "persistent"
    ide0:0.deviceType = "disk"

    ide1:0.present = "TRUE"
    ide1:0.fileName = "F:\knoppix-iso\KNX5.1.1J_AC.200.iso"
    ide1:0.deviceType = "cdrom-image"

    ethernet0.present = "TRUE"
    ethernet0.connectionType = "nat"

    usb.present = "TRUE"

    displayName = "hokan saki"
    guestOS = "other26xlinux"
    nvram = "hokansaki.nvram"
    この構成で仮想マシンを起動する前に、仮想マシンから作業場(具体的には、ダンプしたイメージファイルの置き場所)が見えるようにする設定を忘れずに。VMware Player のバージョン3 には、「仮想マシン設定の編集」という GUI が用意されているので、そこから作業場のハードディスクを追加するだけだった。

  4. 空っぽの仮想ディスクを fdisk でフォーマット。上記の構成なら、くだんの空っぽの仮想ディスクは /dev/hda として認識されているはずなので、
    $ sudo fdisk /dev/hda
  5. partimage で、ダンプした対象 HDD のイメージファイルを /dev/hda1 にリストア。partimage を実行する前に、対象 HDD のイメージファイルの置き場所をマウントしておくこと。イーサネットだと、たぶんすごい時間がかかる。ついててよかった eSATA。

  6. ブートローダの修復。GRUB ならこんな感じ。
    $ sudo mount /dev/hda1 /media/hda1
    $ sudo chroot /media/hda1
    $ grub-install /dev/hda
    (マウントのときは Knoppix の UI を使わず、コンソールから mount コマンドで実行すること(Knoppix についてくる /etc/fstab の設定のせいで読み取り専用になってしまうため)
    あと、fdiskで領域(この場合は/dev/hda)をブート可能に設定しておくこと。

  7. BIOS の CD/DVD ブートを解除すれば、物理マシンで稼動していたシステムがそっくり VMware Player 上で起動するようになるはず。

2010/03/22

TeXでFizzBuzz

shibuya.lisp の テクニカルトーク#5 で、はやみずさんが「LaTeXでFizzBuzzを書く気になるか?」的な話を一瞬されたので反応しておく。そう言われて始めて書いてみようかと思うくらいだから、「書く気になるか?」という問いに対する答えは否定的なものであっていると思う。
\newcount\a \newcount\b \newcount\c
\newcount\n \newcount\i
\newif\ifdivisable

\def\fizzbuzz#1{%
\n=#1 \i=1
\loop \ifnum\i<\n
\printffizzbuzz
\advance \i by 1
\repeat}

\def\printffizzbuzz{%
\testdivisable{\i}{15} \ifdivisable fizzbuzz\par \fi
\testdivisable{\i}{3} \ifdivisable fizz\par \fi
\testdivisable{\i}{5} \ifdivisable buzz\par \fi
\ifdivisable\else \number \i\par \fi}

\def\printffizzbuzz{%
\testdivisable{\i}{15} \ifdivisable fizzbuzz \else
\testdivisable{\i}{3} \ifdivisable fizz \else
\testdivisable{\i}{5} \ifdivisable buzz \else
\number \i \fi\fi\fi \par}

\def\testdivisable#1#2{%
\a=#1 \b=#2 \c=#1
\divide \a by \b
\multiply \a by \b
\advance \c by -\a
\ifnum\c=0 \divisabletrue \else \divisablefalse \fi}

\fizzbuzz{30}

\vfill
\eject
\end
(2010.3.23 rudolphさんの指摘を受けて\printffizzbuzzを修正)

LaTeXじゃなくて素のTeX。これを fizzbuzz.tex のような名前で保存して tex fizzbuzz と実行すれば dvi ができる。

整数の計算には、\newcountコマンドでグローバルなレジスタをいくつか用意して、これを使う。これは文字通りのレジスタ計算で、レジスタに入っている値をadvancedivideといったコマンドを使って書き換えながら計算を進めていく。

リストやシーケンスのような気が利いたデータ構造は当然存在しないので、ループを使ってFizzBuzzするしかない。素のTeXでは、\loop... \repeatという構文が用意されていて、これでループが書ける。

あとトリッキーなのは、\newifというマクロを使って\ifdivisableという特定用途のための条件文を用意するところだろう。まあ、なんていうか、このへんはイディオムなので深く考えない。最初に見るとぎょっとするし、もっとうまい記述方法がないか考えても見るけど、結局こういうイディオムを使って書くのがいちばんしっくりくることに気がつくものだ。

2010/03/04

pLaTeX+dvipdfmxで基本じゃないOTFフォントを使う

ヨドバシカメラのソフト売り場で大枚はたいてOTFフォントを買ったならば、とりあえずpLaTeXでも気軽に使いたい、それもWordくらい気軽に、という話。

具体的には、「本文のゴシックはヒラギノ基本書体の角ゴW3でいいんだけど、強調したいところで角ゴW4を使いたい。ヒラギノ角ゴW4は買ってきた。原稿で\hirakakufour{モナド}って使いたい!」という状況がままあって、場当たり的な試行錯誤で「とりあえず」期待どおりの結果は得られているが、なにぶん試行錯誤でたどりついた方法なので正解かどうかはわかりません、つっこみ求む、という話。

TeXにおけるフォントとは何か、を整理する必要があるので、肝心の手順にいたるまでの説明が長くなります。まずは基礎知識。
買ってきたフォントの実体は .otf ファイルだけど、TeXが必要としているのは .tfm というファイルである。(.vf ファイルもあるけど、ややこしいので省略)
TeXのソースで指定するのは、あくまでも .tfm ファイルの名前である。.tfm ファイルには、TeXがそのフォントの文字を配置するときの幅とか前後の文字とのアキといった数値情報(メトリック)だけが入っている。これはバイナリファイルで、極端にいうとフォントの実体とぜんぜん関係ない値であっても、とにかく数値情報が決まったフォーマットでエンコードされていればいい。TeX のコマンド(platex とか)にとっては、フォントの実体なんて知ったことじゃないのである。TeX の仕事は、各ページへの要素の配置を決めるアルゴリズムを駆使して、その結果を dvi ファイルとして埋め込むだけ。それにはフォントのグリフを並べるのに必要な数値情報だけ知っていればいい。(この「なんでも数値にしてアルゴリズムさえ考え抜けばいいじゃん」という方針をクヌーシズムと称したい。)
TeX は、「この要素には○○というフォントを使って!」という情報だけをdviファイルに書き出す。
○○は、この場合は .tmf ファイルの名前。
フォントの実体は、dviファイルを解釈するDVIウェアと呼ばれるソフトウェアが扱う。
dvipdfmx や dviout といったDVIウェアが、フォントの実体である .otf ファイルを扱うので、彼らに .tfm ファイルと .otf ファイルとの対応付けを教えなければならない。

次に、ここでまとめる手順の前提条件。
ようやく手順。
  1. 何はともあれヒラギノ角ゴW4用の .tfm ファイルが必要。ここが肝要なんだろうけど、まあ角ゴW4のメトリックは角ゴW3とそんなにかわらないはずだよね、と仮定して、齋藤さんのOTFパッケージの nmlgothb-h.tfm および nmlgothb-h.tfm をそっくりコピーして使わせていただく。このへんが「とりあえず」なゆえん。(もしかするとヒラギノ角ゴW8用の tfm のほうが適切かも。)
    $ cd (TEXMF)/fonts/tfm/ptex/otf/otf  # パスとコピー先は各自でてきとうに
    $ cp nmlgothb-h.tfm nmlgothlb-h.tfm
    $ cp nmlgothb-v.tfm nmlgothlb-v.tfm
    (本来は、メトリックをS式っぽいもので記述したPLファイルというのを作って、それをpltotfというツールで変換してtfmファイルを作るらしいが、自分でやったことはない。OTFパッケージのうれしさは、ヒラギノ基本6書体に対してこれらをすべてお膳立てしてくれることにある。)
  2. dvipdfmxに、.tfm ファイルと .otf ファイルの対応付けを教える。これは、次のような map ファイルを書いて、dvipdfmx の実行時に -f オプションで指定すればよい。
    $ cat hirakakufour.map
    nmlgothlb-h H HiraKaku-W4.otf
    nmlgothlb-v V HiraKaku-W4.otf
  3. フォントの実体 HiraKaku-W4.otf を、dvipdfmx から見える場所(/usr/share/texmf/dvipdfmx/fonts/ とか)におく。

これで、たとえばこんな風にすれば、ヒラギノ角ゴW4を \hirakakufour コマンドで使えるようになる。
\DeclareFontShape{JY1}{gt}{lb}{n}{<-> nmlgothlb-h}{}
\DeclareFontShape{JT1}{gt}{lb}{n}{<-> nmlgothlb-v}{}
\def\hirakakufour#1{%
{\usefont{JY1}{gt}{lb}{n}#1}}

2009/12/30

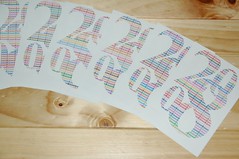
年賀状かいた。
%!
<< /PageSize [285 420] >> setpagedevice

1 1 25 {
/n exch def
0 12 360 { % for
/i exch def

newpath
gsave
/r1 {rand 5 mod 2 div} def
/r2 {rand 2 mod 2 div} def
/r3 {rand 2 mod 2 div} def
r1 r2 r3 setrgbcolor
140 220 moveto
i rotate
/Times-Bold findfont 10 scalefont setfont
( ) show
0 10 20 { % for
/j exch def
/AgentOrange findfont j 12 add scalefont setfont
(2) show
/AgentOrange findfont j 14 add scalefont setfont
(0) show
/AgentOrange findfont j 16 add scalefont setfont
(1) show
/AgentOrange findfont j 18 add scalefont setfont
(0) show
} for
grestore
} for
220 45 moveto
/Georgia-BoldItalic findfont 10 scalefont setfont
n =string cvs show
(/25) show
showpage
} for

DSC_0178

こちらのAgentOrangeというフリーフォントを使わせていただきました。ありがとうございます。

http://www.1001freefonts.com/AgentOrange.php

2009/12/28

Gauche の CGI スクリプトを lighttpd + FastCGI で動かす手順

Gauche の CGI スクリプトを lighttpd + FastCGI で動かす手順。自分用の備忘録。

FastCGI は、Web サーバと外部プログラム間のやり取りを規定した一種のプロトコル。外部プログラムは起動しっぱなしになっていて、Web サーバは、その起動しっぱなしのプロセスと必要に応じてやり取りする。したがって、外部プログラムには、起動しっぱなしで Web サーバとおしゃべりできる仕組みが必要で、Web サーバのほうも、そんな外部プログラムとおしゃべりできないといけない。

外部プログラム側で必要となる仕掛けは、Gauche の場合、Gauche-fastcgi が提供する with-fastcgi という関数で cgi-main をくるむだけでいい。Gauche-fastcgi のインストールには FastCGI の開発ツールキットが必要。

Web サーバのほうは、lighttpd を使う場合、mod_fastcgi を有効にして、しかるべき設定をする。lighttpd の設定ファイルは /etc/lighttpd/lighttpd.conf なので、まあこれを編集してもいいのだけれど、Debian では lighty-enable-mod というユーティリティがあるのでこれを使う。具体的には、/etc/lighttpd/conf-available/ 以下に nn-name.conf という形式の名前を付けたファイルで設定の断片を用意し(nn は優先順、name は名前)、lighty-enable-mod name を実行する。最初から用意されている nn-name.conf ファイルもいくつかあって、10-fastcgi.conf という FastCGI 用のものもあるけれど、きっと Gauche で書いた FastCGI スクリプトには対応していない。だから、代わりに次のような内容の 10-fastcgi.conf を用意する。
server.modules   += ( "mod_fastcgi" )

fastcgi.server = (
"sample.fcgi" => ((
"host" => "127.0.0.1",
"port" => 1026
)),
"index.fcgi" => ((
"host" => "127.0.0.1",
"port" => 1027
))
)
sample.fcgiindex.fcgi が、 Gauche で書いた実行可能なスクリプトのファイル名。この設定は、「クライアントから sample.fcgi を要求されたら、localhost 上のポート 1026 で動きっぱなしの sample.fcgi に処理させますよ」などと読む。というわけで、事前に localhost 上のポート 1026 で sample.fcgi を動きっぱなしにしておく必要がある。そのために使うのは spawn-fcgi という lighttpd に付属するコマンド。
$ sudo spawn-fcgi -f /var/www/sample.fcgi -p 1026 -u www-data -g www-data
$ sudo spawn-fcgi -f /var/www/index.fcgi -p 1027 -u www-data -g www-data
これで、FastCGI でのおしゃべりをポート 1026 (あるいは 1027)で待ち受けるプロセスが立ち上がる。なお、sample.fcgiindex.fcgi に実行権限が付与されてないと(chmod 755 されてないと)、spawn-fcgi がエラーになる。また、Gauche のエラーでプロセスが死んでも spawn-fcgi そのものは成功してしまうので、spawn-fcgi の実行後に ps awx | grep gosh して起動しっぱなしのプロセスがあることを確認したほうがいい。

この後、lighttpd を起動する。すでに起動していて再起動する場合は、設定ファイルの再読み込みもしておく。
$ sudo /etc/init.d/lighttpd force-reload
$ sudo /etc/init.d/lighttpd restart
これで準備はおしまい。リロードしまくっても新しい gosh プロセスが毎回起動しなければOK。

なお、この手順は、事前に動きっぱなしにしておいた外部プログラムをIPアドレスとポートで識別する方法。識別に UNIX ドメインソケットを使うこともできる。また、外部プログラムを事前に起動しておかず、初回は lighttpd から起動させることもできる。細かい話は lighttpd の mod_fastcgi のドキュメントにいろいろと書いてあった。

2009/07/29

DebianでWillcom端末からPPP接続

Debian/GNU Linux(squeeze)に Willcom の PHS 電話端末 AH-J3003S(ウィルコム定額プランで契約)を USB でつなぎ、契約なしで利用できるプロバイダ PRIN にダイアルアップして PPP でインターネットに接続するときのメモ。

まず、避けて通れないプロバイダについて。Willcom 端末からのダイヤルアップ接続には、事前契約が不要な PRIN というプロバイダが使える。使えるんだけど、ずっと料金体系や支払い方法がよくわからず、こわくて使ってなかった。最近になって Windows XP から勇気を出して使ってみたところ、ちょっと外出先で接続するくらいなら気にならない程度の金額だとわかったので、Debianマシンでも使ってみることにした。気になるお値段はPRIN/サービス案内に一覧表がある。Willcom の電話端末を「ウィルコム定額プラン」で契約していれば、「リアルインターネットプラス」を契約していなくても 10円/分 くらい。料金の支払いは、電話料金と一緒に引かれているっぽい(金額が微妙でよくわからないけど、ほかから請求がこないので)。

AH-J3001S という端末は、Linux Kernel からは ACM デバイスとして認識される。cdc-acm モジュールが有効になっていれば、USB ケーブルでつなぐだけで、こんな感じに認識されるはず。
$ tail /var/log/messages
...
... cdc_acm 4-2:1.0: ttyACM0: USB ACM device
... usb 4-2: New USB device found, idVendor=1145, idProduct=0001
... usb 4-2: New USB device strings: Mfr=0, Product=0, SerialNumber=0
...
というわけで、必要な作業は、PPP の設定のみ。

Debian での PPP 接続には ppp パッケージが必要。それと、設定ファイルを編集する pppconfig というユーティリティーを使いたいので、 pppconfig パッケージもインストールする。
$ sudo apt-get install ppp pppconfig
インストールできたら、pppconfig を使って、モデムのデバイスファイルやプロバイダの情報(ダイアルアップ先やユーザ名やパスワードなんか)を設定する。モデムのデバイスは /dev/ACM0 にする。プロバイダがらみの設定値は、PRIN/サービス案内(アクセスポイント一覧がある)やPRIN/各種設定・利用案内(Windows XP のウィザード設定画面の説明がある)とかから探せば見つかる。

pppconfig による設定は /etc/ppp/peers/ および /etc/chatscripts/ 以下にテキストファイルとして保存される。手元の設定結果はこんな感じ。
$ cat /etc/ppp/peers/willcom
# This optionfile was generated by pppconfig 2.3.18.
#
#
hide-password
noauth
connect "/usr/sbin/chat -v -f /etc/chatscripts/willcom"
debug
/dev/ttyACM0
115200
defaultroute
noipdefault
user "prin"

ipparam willcom

usepeerdns
$ cat /etc/chatscripts/willcom
# This chatfile was generated by pppconfig 2.3.18.
# Please do not delete any of the comments. Pppconfig needs them.
#
# ispauth CHAP
# abortstring
ABORT BUSY ABORT 'NO CARRIER' ABORT VOICE ABORT 'NO DIALTONE' ABORT 'NO DIAL TONE' ABORT 'NO ANSWER' ABORT DELAYED
# modeminit
'' ATZ
# ispnumber
OK-AT-OK "ATDT0570570611##61"
# ispconnect
CONNECT \d\c
# prelogin

# ispname
# isppassword
# postlogin

# end of pppconfig stuff
なお、このファイルには書き出されてないけど、プロバイダのパスワードにはユーザ名と同じ prin を設定する(公開情報)。

で、いよいよ接続するには pon コマンドを使う(利用するユーザは dip グループに入っていないといけない)。
$ pon willcom
willcom の部分は、pppconfig による設定の際に指定する設定名。これは /etc/ppp/peers/ なんかの下にあるファイル名でもある。ifconfig してみると ppp0 みたいな名前のインタフェースが新たに現れているはず。切断は poff で。

2009/07/10

LaTeX におけるページをまたいだ囲み記事スタイルのまとめ

追記(2014年11月7日)

いまなら、囲み記事を書きたい場合には tcolorbox パッケージを使うのがよさそうです。 さらに脚注問題については footnoteパッケージというのが 1997 年からありました orz 方法は違うけど、以下の記事でやっている「段落ボックス中の \footnote を外側に追い出す」ができます。 まとめるとこんな書き方をすればよさそう。
\documentclass[a4paper]{article}
\usepackage{lipsum}
\usepackage[most]{tcolorbox}
\usepackage{footnote}
\tcbuselibrary{breakable}
\newtcolorbox{mybox}{breakable, enhanced jigsaw}
\makesavenoteenv[myftnbox]{mybox}

\begin{document}
\lipsum[1]

\begin{myftnbox}
\lipsum[1]

First footnote\footnote{first footnote}.

\lipsum[1-10]

Second footnote\footnote{second footnote}. 
\lipsum[1]
\end{myftnbox}

\lipsum[1]

\end{document}

ただし、tcolorbox に breakable を設定した環境では、minipage でもないのに minipage 専用の独立した脚注番号用のカウンタ mpfootnote が minipage っぽく使われてしまっているため、footnote パッケージはこれを通常の mpfootnote のように外側の脚注番号用カウンタと同期できません。そのため、上記のままでは、myftnbox 環境内だけは脚注番号が毎回 a, b, ... になってしまい、外側の 1, 2, ... と同期できません。ページをまたいだボックス環境で、ドキュメント内で一貫した脚注番号を使うには、何か自分で工夫をするしかなさそうです。

というわけで、以下の本文では、そのための工夫の一例を紹介します。実際に適用してみた結果はこちら


LaTeX でページをまたいだ囲み記事を実現するスタイルはいくつかあって、今のところ回避困難な制限がある。そのまとめ。

基本は framed.sty だろう。角が四角くてもいいなら、これがいちばん素性がいい感じ。ただし、ページをまたぐときに、前のページの末尾と次のページの先頭に罫線が入る。標準的なパッケージなので、いろんな環境で利用できる可能性が高い。たぶん中身をボックスにいれて \vsplit で一行ずつページを構成する垂直ボックスに渡していく方式。

もうひとつ、 eclbkbox.sty というのもある。これはページをまたぐ箇所に罫線が入らない。これもやはり角は四角い。これも \vsplit を使う方式。

同じく \vsplit を使ったページ分割手法で、しかも角丸に対応したスタイルとして、emath の itembkbx.stymultipagebox.sty がある。

さて、以上の4つのパッケージには共通する悩ましい制約条件がある。\footnote がまったく使えない。翻訳なんかだと囲み記事に脚注入れたい場合もあるというのに、いれられない。いろいろ回避策を考えてみたけど、\vsplit を使うにはいったん囲み記事にしたい中身をボックスに入れるしかなく、その時点で \footnote を見るしかなくて、\vsplit するときには手の出しようがない。そもそも \vsplit はインサートの分割アルゴリズムを利用するためのプリミティブだから、やはりインサートである \footnote に対応できなくてもしょうがないか(実際には直接の関係はないけど)。

以下のようにして簡単に \footnote を有効にできる場合がある(全部試してない。使えない環境も多々あるはず)。
\newtoks\mftn
\def\mfootnote#1{%
\footnotemark
\edef\@tempa{\the\mftn\noexpand\footnotetext[\the\c@footnote]}%
\global\mftn\expandafter{\@tempa{#1}}}%
\def\mfootnoteout{%
\the\mftn
\global\mftn{}}

\begin{...}
\let\footnote\mfootnote
...
\end{...}
\mfootnoteout
ただしこの回避策だと、\footnote の項目がページごとではなく最後のページにまとめて出てしまう。まあ、最後の手段ということで。

ページをまたぐ囲み記事で、しかも \footnote に完全対応する方法として、longtable.sty を使って独自の環境をでっちあげるという手がある。(。汎用性がないのでそのままの状態ではたぶん利用不可能。囲み記事の段落を longtable の行に対応させるという荒業のため、段落ごとにしか改ページできない。これが最大の難点。でもまあ、この \longtable を使う方法の難点こそが、\footnote をページごとに出力するための直接の代償でもあるわけだ。)

というわけで、だれか footnote を華麗に再定義して footnoteanyware.sty みたいなのを作ってください。

2009/06/22

Lisp!

Golden Lucky - Lisp (via Keiichirou Shikano)
Lisp

発作的に作ってしまった。

2009/05/24

Goodby Bafana

『マンデラの名もなき看守』を見た。見ることができた。赤ちゃんがいると映画館にいく機会は限られるのだけど、今日はたまたまそういうチャンスだった。そして、たまたま今週の早稲田松竹のラインナップが『マンデラの名もなき看守』だった。ついてた。

映画では、旧体制の南アにおける黒人差別政策についてどうこう言うこともなく、看守としてマンデラとかかわるたびに気がついたら人生の窮地に立っている男とその家族の話をテンポよくつないで、1990年2月11日の釈放シーンで締めくくっている。じわじわくる。ラストまでのエピソードのおかげで、最後の"goodbye bafana"というセリフの手前くらいで涙が出そうになる。そして釈放シーンの看守の奥様がとてもきれい。この2つのシーンは、もっと感動的に演出してもよさそうなものだけど、これでちょうどよかったのだろうな。

現代史に散らばっている社会問題って、「かわいそう」駆動型の活動や「正義感」駆動型の行為、あるいは思考停止になりがちだ。自分は正直なところ思考停止していると思う。それを「娯楽」の形で消化する贅沢に折り合いを付けるのは難しいし、たぶん付かない。『ホテルルワンダ』もそうだった。でも、たとえばダライ・ラマ14世の亡命後の半生を描いた映画ができれば、きっと見に行く。贅沢はくせになる。

2009/05/23

A rant about happiness

タイ料理屋でしこたまのみながら、「幸福」を定義した。
手元にメモが残っているので、思い出しつつ書き起こしておく。

「幸福」とは何かよくわからないので、まずは「幸福でない」について考えよう。

レベル1の「幸福でない」とは、幸福の軸が定まっていて、幸福の側にいない状態。
レベル2の「幸福でない」とは、レベル1の「幸福でない」を定めるすべがない状態。つまり、この場合は、レベル1における幸福の軸を見出せていない状態。

この定義から、レベルnの「幸福でない」を自然に拡張できる。
レベルnの「幸福でない」とは、レベルn-1の「幸福でない」を定めるすべがない状態だ。

で、レベルωの「幸福でない」とは何かを考えてみる。ωは最初の可算無限基数。たぶん、任意の可算基数レベルの「幸福でない」を定めるすべがない状態、なんだろうな。

ということは、ある可算基数があって、そのレベルで「幸福でない」を定めるすべがあれば、レベルωで「幸福でない」ではないといえる。「幸福でない」の逆が「幸福」とは限らないけど、まあ、「幸福になりうる」っていうくらいならいいだろう。とくに、レベル1で「幸福でない」を定めるすべがあれば、レベルωで幸福になりうる。

ここまで書いて気づいたけど、べつに無限基数まで拡張する必要なかったか。
レベル1で「幸福でない」を定めるすべがあれば、どんなレベルでも幸福になりうる。

ところで、いまうちらはレベル1の「幸福でない」を定めるすべを持っている。実際、定めることができている。したがって、うちらはどんなレベルでも幸福になりうる。

おや、なんだかあたりまえの結論じゃないか。
そんな話だったっけかなあ。これだから酔っ払いは。

2009/04/23

LaTeXでSubversionのキーワード展開を使うパッケージ

LaTeX で Subversion のメタ情報(つまり、$Id$ とかのキーワード展開)を使いたい。

Subversion におけるキーワード展開について基本をまとめると、たぶんこんな感じ。
  • 各ファイルのsvn:keywords属性を展開したいキーワードに設定する。
  • 原稿ファイル中にある $Id: ... $ などが展開されるのは、svn checkout や svn update でリポジトリの変更を取ってきた時点。
困っちゃうのは、ファイルごとにしかメタ情報を使えないところ。LaTeX で原稿を複数のファイルに分けて執筆している場合に、1ページめに原稿全体としての最新リビジョンを出力するようなことができない。1ページめをコンパイルする時点では、そのページの元になっている *.tex ファイルの $Id: ... $ しか展開されなからだ。後ろのほうのファイルだけが更新されたら、その新しいリビジョン番号には追随できなくなってしまう。
この悩みを解決する LaTeX のパッケージがいくつかある。svn-multi が新しいめで高機能そうなんだけど、今回は svninfo を使うことにした。以下は備忘録。

book.tex から zenhan.tex と kouhan.tex を include していて、Id キーワードの情報が使いたいとする。
% プリアンブルいろいろ
\begin{document}
\include{zenhan}
\include{kouhan}
\end{document}
まずは svninfo パッケージを利用できるようにする。\usepackage{svninfo} は \begin{document} の直前に置かないといけないようだ。
% プリアンブルいろいろ
\usepackage{svninfo}
\begin{document}
\include{zenhan}
\include{kouhan}
\end{document}
つぎに以下のような行を zenhan.tex と kouhan.tex に追記する。最後の $ のあとにスペース必須。 "file rev YYYY-MM-DD hh:mm:ss owner" の部分は、現在のファイルの情報(svn log -rHEAD zenhan.tex とかで得られる情報)か何かを手書きしておく。
\svnInfo $Id: file rev YYYY-MM-DD hh:mm:ss owner $ ← スペースあり
忘れずに svn:keywords を設定してコミット。
> svn propset svn:keywords "Id" *.tex
> svn commit -m"added svnInfo Id"
準備はこれでOK。この情報を LaTeX で出力するには、\svnId とか \svnInfoRevision といった svninfo のコマンドを使う。
複数のファイルにある $Id: ... $ を全部チェックして最新のリビジョン番号をとってきてくれる \svnInfoMaxRevision というコマンドもある。この \svnInfoMaxRevision をzenhan.tex に書いておけば、最新のリビジョンで更新されたのが kouhan.tex だけでも、その最新のリビジョン番号に展開される。たとえば、zenhan.tex に対する最後の変更がリビジョン 1000 で、kouhan.tex だけが 1001 で変更されたとすると、どんなに svn up しても zenhan.tex にある $Id: ... $ の部分はリビジョン 1000 に相当する情報にしか展開されない。ところが \svnMaxRevision のほうは 1001 に展開されてくれる。
svninfo に用意されているほかのコマンドは、マニュアルのPDFを参照。

The svninfo package(PDMマニュアル)
http://ftp.yz.yamagata-u.ac.jp/pub/CTAN/macros/latex/contrib/svninfo/svninfo.pdf

2009/04/21

Gauche の string-split が便利だ。便利なんだけど、セパレータとしてプロシージャを渡したとき、文字列にある各文字に対してプロシージャが順番に呼ばれないっぽいのが困る。
まずはふつうの例。こんな文字列があったとき、
(define text-with-block
"words, |entering a block|, got out of the block.")
スペースかどうか判断するプロシージャを is-space? 渡して、この文字列をぶったぎりたい。
(define is-space? (pa$ char=? #\space))
(string-split text-with-block is-space?)
=> ("words," "|entering" "a" "block|," "got" "out" "of" "the" "block.")
これは問題ない。
今度は、文字列のうちで縦棒 "|" でくくられている部分を塊とみなし、その内部にあるスペースは無視したいとする。つまりこんな結果がほしい。
(string-split text-with-block is-isolated-space?)
=> ("words," "|entering a block|," "got" "out" "of" "the" "block.")
クロージャーの出番です。is-isolated-space? はこんな定義でいいだろう。
(define is-isolated-space?
(let ((inblock? #f))
(lambda (c)
(cond ((char=? c #\|)
(set! inblock? (if inblock? #f #t))
#f)
(inblock?
#f)
((char=? #\space c)
#t)
(else
#f)))))
実際、 text-with-block に対して is-isolated-space? を繰り返し呼べば、縦棒 "|" でくくられた内部がセパレータとみなされないことが確かめられる。
(let R ((ls (string->list text-with-block)))
(cond ((null? ls)
'())
((is-isolated-space? (car ls))
(cons 1 (R (cdr ls))))
(else
(cons 0 (R (cdr ls))))))
=> (0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 1 0 0 0 1 0 0 1 0 0 0 1 0 0 0 0 0 0)
見づらいけど、 "|entering a block|," の位置に相当する部分がぜんぶゼロになっているのがポイント。
だから、string-split に渡したプロシージャが文字列にある各文字に対して順番に呼ばれるなら、目的の結果が得られるはず。でも得られない。
(string-split text-with-block is-isolated-space?)
=> ("words," "|entering" "a" "block|, got out of the block.")
しかも、もういっかい呼び出すと結果が変わる。
=> ("words, |entering" "a" "block|, got out of the block.")
ということは、各文字ごとに is-isolated-space? の抱えているクロージャがクリアされているわけではないんだよな。2回目の呼び出しでは、inblock? の初期値が #t になっているようだ。
ちなみに、マニュアルにはこうある。

splitter に手続きが与えられた場合、string にある各文字に対してその手続きが呼ばれ、
splitter が真の値を返すような連続した文字群がデリミタとして使われます。
また、ソースの stringutil.scm にある string-split の定義を見ると、ふつうに文字列の先頭から各文字をプロシージャーで処理してるっぽい。なにがおかしいのかなあー。
仕方がないので代わりの関数をでっちあげる。
(define (string-split-by str proc)
(let ((n (string-index str proc)))
(if n
(receive (h r)
(values
(string-take str n)
(string-drop str n))
(if (= (string-length r) 0)
'()
(if (> n 0)
(cons h (string-split-by (string-drop r 1) proc))
(string-split-by (string-drop r 1) proc))))
`(,str))))

(string-split-by text-with-block is-isolated-space?)
=> ("words," "|entering a block|," "got" "out" "of" "the" "block.")

2008/12/30

ようやく年賀状を作る。

DSC_0201

どうみても図形言語です。

にしても今年は一年中なんだか余裕がなかった。来年はなんとかする。

2008/09/26

Scheme どう書く?的 - ひげぽん OSとか作っちゃうかMona-
http://d.hatena.ne.jp/higepon/20080925/1222326246

こんなことをしていられる状況ではないんだけど、mapAccumLを使いたい衝動を抑えられなかった。
compactNumberList :: [Int] -> [[Int]]
compactNumberList = snd . partition ([]==) . tail . snd . mapAccumL collect [-1] . (++[-1])
where collect xx@(x:xs) y | y - x == 1 = (y:xx, [])
| xs ==[] = ([y], [x])
| otherwise = ([y], [last xx, head xx])

2008/09/12

IO型は、使うだけなら簡単に思える。たとえば String -> IO () という型の putStr に文字列を渡せば、それが画面に印字される。
Main >putStr "abcdef\n"
abcdef
putStr の出力は IO () 型なので、結果として印字された「abcdef」は文字列ではない。じゃあ、IO () 型の出力はどこにいったんだろう? Show クラスのインスタンスがないということ? でも、だとしたらGHCがエラーを出力するんじゃなかったっけ?

とにかく絶対に IO () な何かが関数の結果として返ってきているはずなので、IO () -> String な関数を定義してそれに putStr をつないでみた。
vacant :: IO () -> String
vacant o = "munashii"
Main >vacant $ putStr "subarashii\n"
"munashii"
どうして「subarashii」が印字されないん?

結局、これはやっぱり副作用じゃないってことなんだろうな。Scheme でも同じことをすると、
gosh> (define (vacant o) "munashii")
vacant
gosh> (vacant (print "subarashii"))
subarashii
"munashii"
これが本物の副作用ということなのか!

2008/09/11

Haskellでプログラムを書くときは、まず関数の型を妄想してHoogleしろ

Haskellでは、型を「利用して」プログラミングができるという。つまり、「あーなんかこんな型の関数ねえかな」というところからプログラムを書き始めるものらしい。だから haskell.org では型からAPIを検索することができる。その名も Hoogle。Gauche のリファレンスマニュアルさえあれば誰にでも Scheme のプログラムが書けてしまうように、Hoogle があれば誰にでも Haskell のプログラムが書ける。気がする。ところで、Yahooみたいな名前の APIサーチエンジンもあるそうなのですが、見つかりません。
(追記)Hayooでした。ありがとうございます > nobsun(ここまで追記)

たとえば、10進の整数を各桁からなるリストだと思って map したい。
*Main> intMap (*2) 12345
[2,4,6,8,10]
*Main> foldr (+) 0 $ intMap id 123456789
45
こういうintMapをどうやって作っていくか。(以下、とりあえず正の整数の場合だけを考える。)

Scheme脳の正攻法は、各桁の再帰だろう。1の位を head、それより大きな位を tail にして再帰的にリストを作り、reverse すればよさそうだ。10進数の 1の位の数は (mod 10) だし、10で割って floor を取れば 1の位より前にある数字を並べた数になるので、型を考えずにこんなナイーブな定義が書ける。
intMap p n | n < 10 = [p n]
| otherwise = reverse (p last : reverse front)
where
last = mod n 10
front = intMap p (floor (n/10))
ちなみにこれはコンパイルに通らない。floor とか (/) とかは、そのままでは Int型に対して使えないので。コンパイルするには最後の front を次のようにする必要がある。
front = intMap p $ fromEnum $ floor $ toEnum n/10
(追記)整数の割り算がありました。front = intMap p (div n 10) でOK。(ここまで追記)

本来なら順番が逆だけど、ここで初めて intMap の型について考える。intMap は、ふつうの map のように、1引数関数とリスト代わりの整数をとってリストを返すようにしたい。つまり、こういう型だ。
intMap :: (Int -> a) -> Int -> [a]
自分が求めている型が分かったので、これをキーワードにして Hoogle で検索してみる。結果はいっぱい出るけど、その先頭には iterate という関数がひっかかるはずだ。リンクをクリックすると、GHCのドキュメントの iterate の項目にジャンプする。その説明によれば、iterate はこんな関数らしい。
iterate :: (a -> a) -> a -> [a]

iterate f x returns an infinite list of repeated applications of f to x:

iterate f x == [x, f x, f (f x), ...]
見るからに intMap の定義に使えそうだ。f として先ほどの定義の front に相当するものを与えてやれば、iterate f 1234 -> [1234, 123, 12, 1, 0, ...] といった具合にリストが得られるので、あとは各要素から mod 10 で 1の位を抜き出せばいい。
(追記)f の定義を fromEnum $ floor $ toEnum m/10 から div m 10 に修正(ここまで追記)
intMap :: (Int -> a) -> Int -> [a]
intMap p n = map (p . lastDigit) $ reverse $ takeWhile (> 0) $ iterate f n
where
f m = div m 10
lastDigit m = mod m 10
再帰がなくなり、標準関数をごにょごにょするだけで求める関数を作ることができた。

まとめ
「Haskellでプログラムを書くときは、まず関数の型を妄想して Hoogle しろ」

おまけ
ナベアツ問題とか。
nabeatsu = [p i | i <- [1..]]
where has3 n = or $ intMap (== 3) n
p i | has3 i || mod i 3 == 0 = "aho"
| otherwise = intMap intToDigit i

2008/08/03

Panasonic CF-R4JにDebianを入れるまとめ

正月に液晶を割ってしまった Panasonic CF-R4J のパーツを入手できたので、修理ついでに Debian GNU/Linux を入れることにした。いままでは購入時にプリインストールされていた Windows XP 上で VMware を使って Ubuntu を利用していたが、やっぱりたまにいらりってくる。
最近は Debian も簡単にインストールできるけど、CF-R4J には光学ドライブがないし、内蔵の無線LANのように使えないと困る機能もある。あと、いままで使っていた Windows XP の環境をそのまま使い続けられるようにしたい。そこで備忘録として作業のまとめ。

目標

プリインストールされている Windows XP はそのままにして、Debian を追加でインストールしたい。

戦略

  1. USBメモリから KNOPPIX を起動し、ntfsresize と cfdisk を使って、Windows XP がプリインストールされた HDD の後半に Debian 用の新しいパーティションを作る。
  2. 別のUSBメモリから Debian のインストーラを起動し、新しいパーティションにインストールする。
  3. 内蔵されている無線LAN を有効にする。

用意するもの


USBメモリから起動するKNOPPIXのイメージを作る

この作業は、プリインストールされた Windows XP 上で行う。以下のサイトの手順に従っただけ。

  [USBメモリでKNOPPIXを起動する]
   http://ryusai.hp.infoseek.co.jp/KNOPPIX_on_USB-01.htm

まとめると以下の通り。
  1. KNOPPIX の iso イメージを入手して DAEMON tools でマウント
  2. 1Gバイトの USBメモリを FAT32 でフォーマット
  3. DAEMON tools でマウントした KNOPPIX をエクスプローラで開き、KNOPPIX フォルダ全体と /boot/isolinux 以下のファイルを、フォーマットした USB メモリの直下にコピー
  4. /isolinux.cfg を /syslinux.cfg にリネーム
  5. syslinux -a :f

USBメモリから起動する Debian のインストーラを作る

この作業は、上で作った KNOPPIX で行う。これも以下のページの手順に従っただけ。

  [USB メモリでの起動用ファイルの準備]
   http://www.jp.debian.org/releases/stable/i386/ch04s04

まとめると以下の通り。デバイス名とかは適宜。
  1. (ここだけ Windows XP でやっておく)128Mバイトの USBメモリを FAT32 でフォーマット
  2. boot.img.gz を入手し、zcat boot.img.gz > /dev/sdb
  3. sudo mount /dev/sdb /mnt/sdb
  4. cp debian-40r4etchnhalf-i386-netinst.iso /mnt/sdb/

HDD のパーティションを切り直す

この作業は、KNOPPIX 上で行う。
  1. (ここだけ Windows XP でやっておく)Cドライブのデフラグ
  2. ntfsresize -i /dev/hda1 で、リサイズできる HDD 領域の大きさを調べる
  3. ntfsresize -s 30000M /dev/hda1 (30000M のところは、上で調べた大きさを参考に適宜)
この時点で Windows XP からは、C ドライブの大きさが指定した大きさに縮小されて見える(この場合だと30Gバイトしか見えなくなる)。ただしパーティションが変わったわけではないので、管理ツールからローカルディスクを見れば、やはり元の大きさのHDDがCというドライブ名の1つのパーティションに占有されているように見える。ちょっとへんな状態。
実際にパーティションを切るには fdisk をするしかない。そこで cfdisk /dev/hda1 を実行する。

ntfsresize 後の cfdisk でやること

ここからが危険なところ。
  1. もともと Windows XP がプリインストールされていたパーティションを削除する。最初に cfdisk を実行すると、HDD の末尾に 3G くらいの空き領域があるように見える。これは CF-R4 のリカバリ領域。Windows XP が入っているパーティションを削除することで全体が1つの空き領域になるため、空き領域として見えていたリカバリ領域が cfdisk からは識別できなくなってしまう。この領域は BIOS レベルで fdisk などでは削除できないようになっているらしいが、それを確かめる勇気はないので、本当のことは知らない。個人的には用心しておいたほうがいいと思う。実際、あとでパーティションの設定を誤って Windows XP が起動しなくなったとき、KNOPPIX からは /dev/hda4 としておもいっきり見える状態になっていた。たぶんこの領域を隠蔽するのに、プリンストールされた Windows XP の機能を使っているんだろう。
  2. 全体が1つの空き領域になっているところに、まずはプリインストールされている Windows 用のパーティションを作る。先に ntfsresize で縮小したサイズ以上の大きさのパーティションにすること。ぴったり同じバイト数で指定すると、ntfsresize で縮小したサイズよりもfdiskで作ったパーティションのほうが小さくなってしまうようだ。そうすると Windows XP が起動しなくなる。もし後続の空き領域に Debian 用のパーティションを作ってフォーマットしようものなら、あふれた部分が失われてしまって Windows XP の環境が復旧できなくなってしまうはず。大きい分には問題ないので、1Gバイトくらい多めの大きさのパーティションにしたほうがいいと思う。
  3. この時点でパーティションテーブルを書き込み、Debian のインストールに使う領域の設定はインストーラにまかせてしまってもいいが、リカバリ領域を失うのは怖いので、この時点で最後に 5G くらい残るようにして、スワップ用とルート用のパーティションを切ってしまう。
  4. 書き込む。もう戻れない。

Debian のインストール

いつもどおりなので省略。ネットインストールに無線LAN が使えないので、有線をつないで実行する必要がある。

無線LANを有効にする

ラップトップ向けのインストールをすれば wlan-tools はインストールされる。CF-R4J の内蔵無線LAN は Intel PRO/Wireless 2200BG で、そのドライバは ipw2200-source というパッケージでインストールすることができる。lenny ならパッケージのインストールは不要。ただし lenny であってもファームウェアは入らないので、別途 ipw2200-fw-3.0.tgz をダウンロードして /lib/firmware に手動で置いておく必要がある。
あとは /etc/network/interfaces をこんな感じに設定しておけば、有線LAN との使い分けも適当にできると思う。
# The loopback network interface
auto lo
iface lo inet loopback

# The primary network interface
allow-hotplug eth0
iface eth0 inet dhcp

# Wireless LAN
auto eth1
iface eth1 inet dhcp
wireless-essid ******
wireless-key **************************

2008/07/27

金曜日、帰り際にうっかりメールを見ると、確率クイズが出題されていた。
xi ≧ 0 かつ Σ xi = 1 となるような乱数 
x1, ..., x10 がほしい。

そこで、区間 [0,1] 上の独立な一様乱数を 9 個作ってソートし、
得られた r1 ≦ … ≦ r9 を使って、
xi = ri - ri-1 としてみた。
(ただし r0 = 0, r10 = 1)

これは平等か?
たとえば x1 の分布と x5 の分布は等しいか?
(数式に頼らずうまく説明せよ)
ようするに、数直線の0~1の間に均等な確率で弾を9発撃ち込むという行為を繰り返したとき、毎回の隣り合う各弾の間隔は同じような幅になると期待していいか、ということでしょう?
 0            ri-1   ri            1
-+--- …… ---+------+--- …… ---+-
`--xi--'
たとえば撃ち込む弾の数が毎回1発だったら、
 0       r1        1
-+-------+---------+-
`--x1--'`---x2---'
いかにも x1 と x2 が同じ分布になりそうだ。撃ち込むのが9発でも同じことだよね。というわけで、この方法で平等な乱数を10個作ることができる。

こう返信しようとしたけど、思いとどまって(というか時間がなかったので)その日は帰宅した。

でも今日、紙と鉛筆を使ってもうちょと考えてみることにした。

追記:以下にはしょうもない間違いがあるので、あとで訂正します。


任意のλ∈[0,1] について、xi がλになる確率 P(xi = λ) を考えよう。 ri より左側に i-1 個の乱数があって、ri+λ より右側に 9-i 個の乱数があるということなので、以下のように書ける。
P(xi = λ) = rii-1 × (1 - ri - λ)9-i
いくつか具体的に計算してみると、x1 がλになる確率は以下のとおり。
P(x1 = λ) = r10 × (1 - r1 - λ)8
= (1 - r1 - λ)8
同様に x2 がλになる確率は、
P(x2 = λ) = r21 × (1 - r2 - λ)7
= r2 (1 - r2 - λ)7
おや、なんだか P(x1 = λ) = P(x2 = λ) とも言えなそうだ。そこでおおざっぱに評価してみる。
   P(x2 = λ) / P(x1 = λ)
= r2 (1 - r2 - λ)7 / (1 - r1 - λ)8
= (r2 / (1 - r1 - λ)) × ((1 - r2 - λ)7 / (1 - r1 - λ)7)
≦ (r2 / (1 - r1 - λ)) ← r1 ≦ r2 なので
= r2 / (1 - r2) ← λ = r2 - r1
最後の式は、r2 = 1/2 なら 1 になる。しかも、もし r1 = r2 だったら、途中の不等号が統合になるので、P(x1 = λ) = P(x2 = λ) になる。撃ち込む弾の数が毎回1発のケースは、この場合に相当していたのか。

というわけで、実は平等じゃない、というのがクイズの答えっぽい。数式を使わない説明としては、1に近づくほど確保しうる xi の大きさが小さくなってしまう確率が高まるから、というのでどうでしょう。

2008/06/14

今日は7ヶ月の妊婦さんが遊びに来て、彼女たちが帰ったら2ヶ月の妊婦さんの夫から電話がきた。うちは去年のあいだ妊娠生活だったわけだけど、けっこう楽しく乗り切れたと思う。

妊娠生活に限らず、日常と違う生活を楽しむにはまともな情報が必要だ。いろいろあさったけど、雑誌の情報(この場合はベネッセの何か)は2ちゃんねるのようなもので、その他大勢の声を確認するには悪くない。しかしそれはまた、意義のある情報を得るには取捨選択が必要なことも意味している。ところが取捨選択するには、そのドメインに対する基本的で正しい認識が欠かせない。そういうときに役立つのが本物の実用書というものだ。文句なしにお勧めするのはこれ。

Arlene Eisenberg, Heidi Eisenberg Murkoff, Sandee E. Hathaway "What to Expect When You're Expecting"(Workman Pub Co, 2002)
http://www.amazon.co.jp/dp/0761121323/

翻訳も出ている。自分は翻訳版を読んだことはないけど、上記をすすめて翻訳を買った妊婦さん(鬼編集者で出版物の出来には人一倍うるさい)によればいい本とのこと。

森田由美、竹内正人訳『すべてがわかる妊娠と出産の本』(アスペクト、2004年)
http://www.amazon.co.jp/dp/4757210795

この本のすごいところは、妊娠にかかわるいろんなトピックを、できるだけ全部できるだけ詳細に説明しようとしていることだ。それも平易な言葉と妊婦の視線で。実際、オリジナルの作者はそのへんの元妊婦さんで、自分が妊娠中に不安だったのに本に書いてなかったことを全部まとめて本にしてやると思い立ち、産婦人科医や研究者なんかに徹底的にリサーチして出版したらしい。

自分はこの本がなかったら、予定日2週間前の午前2時に実家に戻っていた奥様から「破水した」という電話をもらったとき、これから何が起きて、自分が何をすればいいのか、さっぱりわからなかったはずだ。陣痛室から分娩台の脇で臍の緒を切るまで、すべては本に書いてあるとおりのあらすじで進み、要所で迫られる選択にも十分な理解をした上でのぞむことができた。アメリカ人の実用書の作り込みっぷりに改めて脅威を感じた。

もちろん日本にもすごい本はある。

定本育児の百科 上 5ヵ月まで
http://www.amazon.co.jp/dp/4003811119/

この本は「育児」を扱った古典だが、冒頭でかなりのページを割いて出産前の心得や注意事項に触れられている。書かれたのは古いが、インターネットやベネッセから出産育児に関する情報を取捨選択するためのリテラシーを培うにはとてもお勧めだし、内容も今でも役に立つ話ばかりだ(文庫化にあたって、そういうふうに編集されている)。何よりも普通におもしろい。当たり前だが出産後も役に立つので、買っておいて損はないと思う。

ベネッセやインターネットの情報を利用するのは、少なくともこの2冊の後でいいはずだ。もちろん、すべてを鵜呑みにしたりしなければ、いつどんなリソースに触れてもいいんだけど。

2008/06/04

朝一でときどきの雑記帖を見ていてクイズの存在に気が付いた。

与えられた木から、子→親への対応を作る

脊髄反射で回答を思いついたので仕事を始める前に書いてみた。都合15分弱。
(use srfi-1)

;; [name [tree ...]] -> [(tree-head . name)]
(define (child-parent ls)
(if (null? (cdr ls))
'()
(append-map
(lambda (l)
(cons (cons (car l) (car ls))
(child-parent l)))
(cdr ls))))
にしても、「10分で中級、30分で初級」というshiroさんによるレベル設定が絶妙すぎると思う。

ところでむしろ気になるのは、他人が回答に至るプロセスだ。自分はこんな感じの思考過程で上記の定義に至った。
リストのcarと、リストのcdrたちのcarとを、逆順にconsして集めるのね

とりあえずcdrたちに対してmap-appendか

そしてconsで再帰すればいいから、必然的に終了判定はnull?

"(if (null? (cdr ls))"あたりから書き始める
この場合は再帰も単純なので一発で書いちゃうけど、もうちょっと複雑な場合はテスト用のトリビアルな入力データをREPLで評価しながら関数に仕上げていく。あるいは、一発で関数を書いちゃってからテスト用のトリビアルな入力データを使ってREPLで評価し、意図していない結果であれば修正して(再帰の終了条件を修正する場合が多い)、これを繰り返して関数に仕上げていく。だいたいいつもこんな感じ。必要なら最後にCtrl-c tしてテストを作りますよ。gca.el最高!

ところがこのごろ、テストファーストという呪縛に悩んでいる。最初にテストを書け。問題にある「結果の例」とequal?になるテストケースを書けばいいのかな?でも結果のリストの順番はどうでもいいから、equal?になるテストケースをパスするコードを書くのは一苦労だぞ。そういえばGaucheにはリストを集合として同じだと見なす関数があったよな。しかし元の木に循環があったら集合としても同じにならないし……ってなことを考えているうちに、平気で30分は経過してしまう。

この問題はただのクイズだから気にしなくていい、というわけにもいかない。shiroさん自身も「仕事で扱った小ネタ」と書いているように、Schemeでプログラムを書いているときには、こういう小さな関数を大量にスクラッチしている。そのほとんどを書くときは、まず上記のような思考をまとめて、REPLで即興データの評価を繰り返しながら、徐々に関数としてまとめていく。その過程で関数のキワがはっきりしてくるから、そのきわどい条件を含むように即興データをどんどん変更していく。(場合によっては最後にCtrl-c t。)

テストファーストじゃなくてもメンテナンスのためにテストを残してけ、という意見もあるが、これもいまいち納得しきれていない(もちろん理解はできる)。gca.elを使って開発していれば、コードを書いちゃった後でテストを「残す」のは簡単だ。それでも、例えばプログラムの一部としてこの関数を使っていて、後で効率のいいコードにリファクタリングする場合、作り直したコードによって生成されるリストは現在の結果と同順になるとは限らない(その必要もない)。そうなったらユニットテストとして残しておいたテストケースの意味って、ゼロとは言わないけどあまりなくない?リファクタリングのときもテストデータをREPLで評価しながら作業するわけだけど、そのときにユニットテストとして残っているコードがテスト用として適切とは限らないんだよな。

自分は最近、入力と結果の型(っぽいもの)を関数にコメントしておくようにしている。リファクタリングするときは、この型(っぽいもの)の入力にそったデータをでっちあげて、それをREPLで評価するためのテストデータとして使う。そのでっちあげたテストデータは、やはり新しい関数のキワを突くようにどんどん変更していくだろう。人のコードを見るときも、まずはその情報を探す(コメントとしてであれ、コードとしてであれ)。

関数的なプログラミングにおけるテストの意味合いが、純粋によくわからない。なんども言うけど、テストそのものはCtrl-c tすれば作れるので、テストを残しておくことは面倒でもなんでもない。心にひっかかるのは、それって正しいの?という純粋な疑問だ。神様を毎朝拝むのは、一瞬なら面倒ではないかもしれないけど、自分にはそれが正しいことであると納得できないからしない。考えすぎかもしれないけど、何かを習慣として取り入れるなら、それなりに納得(理解ではなく)した上で取り入れたいということです。

2008/05/13


今年の連休の成果はスターウォーズを全編通して見たことだ(アニメ『クローン大戦』を含む)。それでちょっと思ったんだけど、Lisperにとって自分でLispを作ることは、ジェダイにとって自分でライトセイバーを作ることに似ている。おもちゃのLispなんて、少なくともSICPを読めば誰にでも書ける。とくにLispを使ってLispを書くなら、ベースにするLispのreadやシンボルのインターンが使える。今回、はじめてCでひととおりLispっぽいものを書いてみたわけだけど、やっぱり大変だったのはreadとシンボルのインターンだった。だからこんなのがきちんと実行できたのがうれしかった。
es0> (eq? (quote a) (quote a))
#tt
es1> (eq? (cons (quote a)) (cons (quote a)))
#ff

で、ジェダイならライトセイバーを自分で作るわけだ。奪ったライトセーバーを振り回すだけのグリーバス将軍とは、その点が決定的に違う。グリーバス将軍は強いけど、フォースの加護はない。フォースの加護もなしにライトセーバのような前時代の武器を使うのは、回顧趣味にほかならない。ようするにカッコつけてるわけだ。ラムダの加護もなしにLispを使うようなものだ。ポインタの加護もなしにCを使うようなものだ。ところでいまさらCのポインタの話だけど、みんな藤原博文著『Cプログラミング専門課程』を読めばいいと思う。僕がかろうじてCを全然使えないというわけでもないのはこの本があったからだ。けっこう版を重ねているのに柱(ページ番号とかある部分)に誤記が残ってるとか、編集については微妙なとこもあるけど、本当にいい本なので、曙橋界隈で藤原さんを見かけるとこっそりうれしい。

2008/05/06

オレリスプでYコンビネータ

やっぱりリストの再帰ができないとリスプとはいえない。Yコンビネータが定義できるかやってみよう。Yコンビネータを使うと、関数に名前を付けずに再帰ができる。まあ、なんというか、「ラムダだけでここまでできる」みたいなのがうれしい。

これがYコンビネータ("The Little Schemer"より)。
es20> (define Y 
(lambda (le)
((lambda (f) (f f))
(lambda (f) (le (lambda (x) ((f f) x)))))))
(この「Y」という名前は再帰に使うための名前じゃない。)

たとえばリストの長さを計算する関数なら、こんなふうに実現できる。ちっとも再帰関数には見えないかもだけど、Yコンビネータのなかで「再帰する」ことが抽象化されている感じ。
es24> ((Y (lambda (len)
(lambda (l)
(if (null? l)
0
(+ 1 (len (cdr l)))))))
(quote (beans beans we need jelly beans)))
6.000000
なんかちゃんと動いてる!

にしても、もともと「アトムか、ドットペアか」というだけのルールでS式をパーズしようという企画だったので、いまから「'」記法を導入するのはやっかいだなあ。

あと、この例ではnull?を使っているけど、null?は組み込んではいない。null?とか自分のなかで定義するのがリスプなんだと思う。
es0> (define null? 
(lambda (ls)
(if (eq? (quote ()) ls)
#t #f)))


2008/05/05

Cによるはじめてのオレリスプ

できたよできた!とりあえず階乗の関数を定義して計算できるようになった。
k16@miffy:~/myproj/es$ ./es

es0> (define fact
(lambda (n)
(if (eq? n 1)
1
(* n (fact (- n 1))))))
fact
es1> fact
#<closure ( n )>
es2> (fact 10)
3628800.000000
es3>
ソースはこれ。メモリリークしまくっている状態だけど。あとで時間がとれたら感想とか書く。

2008/03/30

S式パーサからリスプへ

先週はS式パーザ(つまりread)をつくったので、今週はcarとcdrとconsをつくった。そのときにevalとapplyをつくったので、ついでに四則演算にも対応した。途中なので結果だけ。
es0> (* 1 2)
2.000000
es1> (+ 42 23)
65.000000
es2> (cons answer (cons is (cons 42 ())))
(answer . (is . (42.000000 . null)))
es3> (cdr (cons mouse (cons dolphin human)))
(dolphin . human)
es4>
はやくSchemeになりたいよう。のこり必要なもの。
  1. 環境(クロージャー)
  2. インターン
  3. プリティプリント
  4. ガーベジコレクション
  5. 末尾最適化
  6. call/cc
2まではSICPの知識だけで十分か。3はまあ、できているといえばできている。4から6はきびしいかな。やり方は理解できると思うけど、Cで書けるかどうかは別問題だ。

2008/03/23

「S式はアトムまたはドットペア」を真に受けてyaccでパースする話

「おまいらはS式が好きすぐる。」という感想にぐっときたので、S式について考え直してみることにした。具体的にはパーザを書くよ。

S式そのものはとてもシンプル。アトムか、ドットペアか。つまり、
S式 : アトム
| ( S式 . S式 )
;
おなじみの (apple orange pizza) みたいなリストは、実際には null で終わっているドットペアの簡略表記にすぎない。この例であれば、その本当のすがたは (apple . (orange . (pizza . null))) という入れ子になったドットペア。そういえば null って本当は何のことなんだろう? いつも()って書いてるから、空っぽなリストぐらいにしかみなしてなかったけど、よく考えるとよくわからん。

まあとにかく、この「アトムか、ドットペアか」という単純な構文ルールだけをパーザジェネレータに与えてS式パーザを作りたい。

YACCを使ってやってみよう。試行錯誤のすえ、構文解析の部分はこんな感じにした。
%{
#define YYSTYPE Sexp*
%}
%token ATOM
%token DOT
%token LPAREN
%token RPAREN
%%
list: { prompt(lineno); }
| list '\n'
| list sexp '\n' { prints($2); prompt(lineno); }
;

sexp: ATOM
| LPAREN sexp DOT sexp RPAREN { $$ = mk_oblist($2, $4); }
;
ここで Sexp はS式をあらわす構造体で、直感的にAtomとPairの共用体として定義した。
typedef struct Sexp {
short type;
union {
struct Atom *atom;
struct Pair *pair;
} u;
} Sexp;
Atomは浮動小数点数か文字列とする。Pairはもちろんcarとcdrで構成される。
typedef struct Atom{
short type;
union {
double num; /* type = 0 */
char *sym; /* type = 1 */
} u;
} Atom;

typedef struct Pair {
struct Sexp *car;
struct Sexp *cdr;
} Pair;
そしてこの Pair を作る関数が mk_oblist。

基本的には以上でおしまい。なんだけど、これだけではリスト表記をパーズできないのでつまらない。リスト表記のための構文規則を付け足せばいい話なんだけど、「アトムか、ドットペア」というS式のシンプルさに無駄にこだわることにして、字句解析のほうで対応したった! もしかしたらちょっとしたプッシュダウンオートマトンの勉強をしたことになったのかもしれないけど、めんどくさいし面白くないので説明は省略。とりあえず自宅のDebian Lenny上ではこんなふうに動くものができた。
$ ./es

es0> (((((42)))))
(((((42.000000 . null) . null) . null) . null) . null)
es1> (the answer is 42)
(the . (answer . (is . (42.000000 . null))))
es2> (() ())
(null . (null . null))

浮動小数点数だと、42という答えがなんだかうそっぽい。

Expand S-expression にちなんで es という名前にしています。ソースはこちら。

es.tar.gz

2008/03/15

Sence of Mathmatics


昨日の夜、なんとなくラジオを聞いていたら、文系にも数学のセンスは備わっていると誰が主張していた。(文系とか数学のセンスといった用語についての質問はうけつけません。そもそも途中でうちのこが泣き出したので、僕の聞き違いだったかもしれない。どうでもいいけど、うちのことツチノコは似ている。見ためが。)

いわく、「マイナスかけるマイナスがプラスになるのは「反対の反対は賛成」と同じことで、そういうふうに言えば文系の人にだってすっきりするんだからね」みたいな話だったんだけど、それは数学のセンスじゃないと思う。

どうしてもこの話から数学のセンスという何かについて語りたいなら、「マイナスかけるマイナス」が「反対の反対」だと小学校の教師に言われたときに、「反対の反対」を「マイナスたすマイナス」と考えなかった理由を問い返すのが数学のセンスだと思う。

で、そんなセンスをもっていても小学校の教師から屁理屈をいうなと罵られるだけなので、数学のセンスに夢や希望を抱くのはやめたほうがいいと思う。


2008/03/11

Gaucheで本を作るのFAQ

Gaucheで本を作る
http://www.slideshare.net/guest7a66b8/gauche/

gauche.night2008の発表後に個別に受けた質問に答えます。


Q. 原稿をXMLで書かせられるってこと?
A. XMLでなくてもいいんだけど、XMLでお願いすることが多いです。

歯切れの悪い答えですみません。ちょっと背景と理由を説明します。

まずは「XMLでなくてもいい」についてですが、実例がいくつかあるので、それらを紹介。

1つめの実例は、『RailsによるアジャイルWebアプリケーション開発』の旧版。このときは、原書のデータはXMLだったんだけど、下訳の時点でプレーンなテキストデータになってしまったため、XMLの原稿ではありませんでした。ただし、あとでDTPソフトを使ってページレイアウトをするオペレータさん向け、つまり人間向けのメタ情報は付いていました。人間向けのメタ情報っていうのは、たとえば箇条書きの行頭に「●」が付いているとか、サンプルコードの始まりと終わりにマークが付いているとか、補足説明の文はタブでインデントされてるとか、そういうやつです。で、どうしたかというと、そんな人間向けメタ情報をなんとなくパーズしてLaTeXに変換するスクリプトをGaucheで書きました。といっても、機械的な判断が可能なように、人間向けメタ情報のエディタでの編集は必要でした。原稿そのものは最後までプレーンなテキストデータを使いましたが(i.e. XMLに加工したりはしていない)、著者がいじれる原稿からmakeいっぱつで印刷用データを生成していたのは一緒です。このときの顛末は過去にまとめたことがあるので、そちらも見てみてください。

『RailsによるアジャイルWebアプリケーション開発』の制作方式

2つめの実例は『マスタリングTCP/IP ルーティング編』です。このときは、とくに最終工程を意識したメタ情報がないテキストの原稿に、僕のほうでXMLタグを付けて、編集用の原稿にしました。著者の方々の校正では、初校や再校といったタイミングでPDFを印刷した校正紙に赤書きしてもらう、従来の方法をとりました(編集部内ではほぼデイリーでPDFを生成していたけど)。もっとも、この本の場合は図版がとても多く、その校正は紙に赤書きというスタイルがいちばん現実的だったというのもあります。編集者がいじれる原稿からmakeいっぱつで印刷用データを生成していたのは一緒です。

3つめの実例は『プログラミングのための線形代数』です。この本は、著者の2人の原稿がまっとうなLaTeXだったので、そのままLaTeXで組んでしまいました。LaTeXの編集では三美印刷さんにお手伝いしてもらっています。なお一般には、著者独自マクロが入り乱れたLaTeXの原稿はうれしくありません。そのまま印刷所には入稿できないからです。LaTeX原稿は最終工程ではポータビリティが低いのです。

「XMLでお願いすることが多い」理由については、次の質問ともかぶるので、ここではパス。


Q. Wikiとか使って原稿書きたいんだけど……
A. おすすめしません。

いや、Wikiを否定しているのではなく、Wikiは技術書の原稿執筆には向かないと思う、という話です。初期的なアイデア出しや、アイデアの相互レビュー、一時的な原稿のプールなんかに使うぶんには、Wikiは技術書の執筆においてもとても優れたメディアです。

でもWikiに依存して書いていると、最終的な本の構造が意識できない。

技術書って、拾い読みしてもいいけど、やっぱり多くは頭から読むものなわけです。そのとき、構造があいまいな本は、とても読みにくい。ここで「構造」というのは、「目次」に近いけれど、もうちょっと体系的な本の姿のことです。新しい概念がいつ説明されるか、どのブロック(章や項)の下に書かれているか、前にどこで言及されていたか、その前後の文脈。こういった本を構成する要素の縦横のつながり方は、その本のわかりやすさにもろに影響します。構造があいまいで見通しが悪い技術書は、初心者の目線で読んでいるとつらい。Wikiで書く原稿はジグソーパズルすぎて、あらかじめ全体像を知っている人(本を書く人)には気持ちがいいけど、その一片ずつを順番に渡されて読むことになる人(本を読む人)にはちんぷんかんぷんだったりするわけです。Webであれば縦横にはったリンクが読んでいる人にとっても十分な手がかりになるのですが、頭から読む本の場合は読んでいる途中で迷子になった感を抱かせないだけのしっかりした構造が必要です。

で、そういう技術書の原稿を書くのにWikiでやれる人っていうのは、限られるわけです(ゼロじゃないですもちろん)。その点では、構造化を強要されるXMLのほうに、書籍の原稿執筆のための形式としての分があると思います。繰り返しになりますが、アイデア出しやアイデアのまとめにはWikiが優れていると思います。でもそれを本にしようとおもったら、頭から読まれることを強く意識して、体系的に再構築する必要があります。

そして、それは技術書の編集者が手伝える仕事でもありますね(むしろ得意なはず)。


2008/03/09

gauche.night2008で発表しました

gauche.night2008のgauche.gongで発表した。プレゼンはこちら。

Gaucheで本を作る
http://www.slideshare.net/guest7a66b8/gauche/


このプレゼンそのものが、下書きのテキストに気ままにXMLっぽいタグを付けて、それからXML→LaTeXへの変換ルールを定義して、そのルールを使ってxml2tex.scmで変換して作ったもの。(実際にルールを使って変換してるのは、latex.scmcnvr.scm。)

仕様の定かでないタグ付けテキストから、いかにちょっとのコードでLaTeXへの変換ルールを作れるかってところを最後にデモで見てほしかったんだったんだけど、時間が足りなかったのでここで補足。

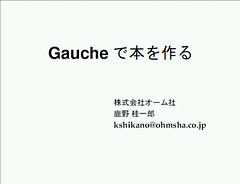
たとえば、1ページ目のPDFはこんな感じで、

cover

原稿はこんなだったんだけど、
<page>
<p0>Gaucheで本を作る</p0>
<p3 vskip="4zh" hskip="12zw">株式会社オーム社開発部</p3>
<p3 hskip="12zw">鹿野 桂一郎</p3>
<p3 hskip="12zw">kshikano@ohmsha.co.jp</p3>
</page>
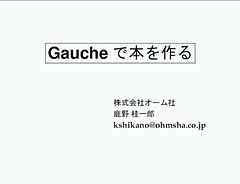
ちょっとタイトルにワクでも付けたいなと思ったら、こんなふうに適当なタグでくるんでみて、
<page>
<p0><box>Gaucheで本を作る</box></p0>
<p3 vskip="4zh" hskip="12zw">株式会社オーム社開発部</p3>
<p3 hskip="12zw">鹿野 桂一郎</p3>
<p3 hskip="12zw">kshikano@ohmsha.co.jp</p3>
</page>
rules.scmにこんな2行を足すだけで(LaTeXの\fboxはワク付の箱でテキストを囲むコマンド)、
(define-tag box
(make-latex-cmd 'fbox))
こんなふうになる。

modified-cover

実際の書籍の原稿だとこんなに単純ではないし、社内で使っているコードはここで公開しているのとは違うけれど、それでもやっていることはほぼ同じです。

謝辞

勢いで申し込んでしまって後悔もしたけれど、Gaucheを実際の商品(書店に並んでいる本)の製作で全面的に使っていることを話せる機会がもらえてよかったです。えんどうさんはじめ、gauche.nightの企画と実現に尽力されているみなさん、本当にお疲れさまでした。デモへの参加を後押ししてくれたhisashimさん、角谷さんと、shiroさんにも感謝です。ありがとうございました。っていうか、shiroさんには、それ以前にGaucheを開発されたことに感謝しないといけないわけですが。shiroさんだけでなく、日々Gaucheの開発とメンテナンスを続けているたくさんの方々にもあらためて感謝です。あと、こんなやり方の本作りに付き合っていただいている著者、訳者、トップスタジオのみなさん、会社のひと、とくにctakaoさんの家の方角には足を向けて寝られないと思ってるんですが、あにいく毎晩その向きで寝るしかない感じです。すみません。

2008/03/06

SICPは、口語では「しっくぴー」と読まれているらしい。
ただし、「あべるそんあんどさすまん」とか「すとらくちゃーあんどいんたーぷりてーしょんおぶこんぴゅーたーぷろぐらむす」といったフォーマルな呼び方を好む人が多いようだ。

SICP - comp.lang.scheme
I wonder what is the correct spelling for SICP abbreviation.

あまり返信が伸びてないなので、英語圏の人たちにとってはどうでもいい話なのかも。いずれにせよ「えすあいしーぴー」という言い方は、あまりしないみたい。

2008/01/19

あまりに憤ったので脊髄反射的に書くけど、そもそもこんなふうにゲラに赤書きしてもらうという本の作り方は悲しすぎます。そして、2月発行予定の書籍に1/11の時点でこれだけの赤字が入っていて、DTPソフトを使って修正する人の作業が間に合うのかとても心配です。おそらくはかなりテクニカルでセンシティブな内容の赤字が入っていると思うので、必ずしも本書の内容を理解しているわけではない人が手作業で各ページごとに絵として修正するには、著者や編集者による修正漏れ確認の手間も含めてとても時間がかかるものだからです。一般に技術書の制作なんてそんなもんだろと言われたら、内情を知る立場ではぐうのねも出ないわけですが、少なくとも僕のチームには「それじゃやばい」という空気がいっぱいだし、そうしない努力もしているつもり。こんな写真が公開されるのは、来月にきちんとしたものが発行されるからこそだという見方もできるのかもしれませんが、この本については読者としてとても楽しみなので、あまり不安にさせるような写真は出さないでほしい。

2007/12/29


年賀状かいた。
%!
<< /PageSize [285 420] >> setpagedevice
newpath
/Times-Bold findfont 340 scalefont setfont
7 200 moveto
(2) false charpath

/Times-Bold findfont 230 scalefont setfont
148 250 moveto
(0) false charpath

/Times-Bold findfont 200 scalefont setfont
10 55 moveto
(0) false charpath

/Times-Bold findfont 440 scalefont setfont
67 10 moveto
(8) false charpath
clip
/Georgia-Bold findfont 13 scalefont setfont
0 11 450 { %for

/r1 {rand 23 mod 17 div} def
/r2 {rand 13 mod 17 div} def
/r3 {rand 17 mod 17 div} def
r1 r2 r3 setrgbcolor
newpath
0 exch moveto
(200820082008200820082008200820082008200820082008200820082008200820082008200820082008) show
} for

DSC_0326

2007/12/27

ケリー・リンクの『マジック・フォー・ビギナーズ』(柴田元幸訳)。英語の日記によれば11月5日に買ったものらしい。ほとんど2ヵ月かけて読んだわけか。本を読むのが仕事だというのに、この遅読っぷり。いろんな人の日記やブログを読んでいると、すごい勢いで書評やら新刊紹介やらが更新されていて、本当にすごいと思う。僕は今年、何冊本を読んだんだろう(仕事として編集したものは除く)。どうして早く読めないんだろう。何につっかかってるんだろう。

たしかにケリー・リンクの小説には、つっかかるところは多い。不条理さとか荒唐無稽さとか、そういう表面的なところにつっかかるんじゃなくて、お話のせつなさにつっかかってしまう。ぶっちゃけ小説の外面がどんなに奇抜だろうと、もともとそういう要素を求めて彼女の本を読んでいるわけだから、その部分は快感なわけだ。快感すぎるわけだ。だからこそ異化された現実感が巧妙に襲ってきて、せつなくなる。もうね、最後に収録されている「しばしの沈黙」なんて、奥様と離れて生活せざるを得ない状況にある男性に読ませたら、間違いなくきゅんとなるよ。僕もスターライトたんに電話して、悪魔とチアリーダーのお話を語ってほしい! あと、今の自分にとっては、「石の動物」に出てくるヘンリーにも共感を禁じえない。彼に限らず、ケリー・リンクの話に出てくる男性は、みんな斜めった現実に抗わなすぎ。そしてそれは、うちらの日常も一緒なんだろうな。そばにいるのが明らかなゾンビとか悪魔じゃなくて、ゾンビとか悪魔っぽい人間ってだけのことで。

ところでケリー・リンクの翻訳作品には『スペシャリストの帽子』もあるけど、もし彼女の作品を初めて読んでみるってことなら、『マジック・フォー・ビギナーズ』のほうをすすめます。訳文の出来が違う。

2007/12/26


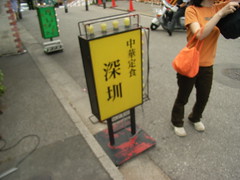
日暮里に「深セン」というあんかけチャーハン専門のこだわり店がある。「セン」の字は、土に川って書くやつね。香港から中国側に川渡ったところの深センと同じ漢字。そういえば昔、深センの駅で写真とってたら、軍人にすごい怒られたことがあったなあ。どうでもいいついでに、個人的に深センといえばチャイナドレス。香港では滅多に見かけないチャイナドレスの女の子だけど、深センに入るとやにわに街に登場する。あれは観光客向けのサービスだったのかもしれない。市場なんかにいたのは、生きたトリを詰め込んだ籠を担いで外人の僕らにまで売ろうとする農民服の女の子とかだったからなあ。2000年ころの話。

で、日暮里の深センの話だけど、このあたりで生活している独身20代男性は毎日通うべきだと思う。うまい。この店の「あんかけチャーハン」は、同じようなメニューを食べさせてくれる店をほかに知らないので説明しにくいんだけど、ようは卵をからめてざっくりと炒めたライスに中華風の一品料理をたっぷりとのせたもの。一品料理のメニューとしては、麻婆豆腐、羊肉炒め、豚角煮炒め、青菜炒め、日替わり(鶏肉と旬の野菜炒めのことが多い)なんかが定番で、夜になると調達した食材に応じてさらに凝ったものが追加される。魚飯とか。こんなところでアドバタイズしてるくらいだから、どれも絶品なわけですよ。しかも安い。笑っちゃうくらいに熱いスープと工夫されたデザートが全品についていて、日替わりなんて600円なんだから。もっと高くてもいいのに。

調理をしているのはマスター一人だし、基本は全部注文を受けてから作るので、タイミングが悪いとけっこう待たされる。でもまあ、調理している手際を見ているだけで相当楽しい気持ちになれる。ビールでも飲んでればいいしね。青島が350円。青島の黒が500円。もうちょっと儲けてもいいんじゃないかって心配になるような値段。

R0011616

この店の料理がどれくらいうまいかっていうと、僕が今日レアメニューのビーフンをうっかり頼んじゃって(チャーハンじゃないメニューをはじめて見た)、ビーフンってのはしいたけ嫌いにとっては第一級の危険食品なわけだけど、やっぱり入ってて、幸い乾燥物じゃなくて生だったので皿全体には被害がなく、全体としてはむしろいつもの深センクオリティで、だからがんばって先に個体だけをビールで流し込んでから残りをおいしくいただいた。それくらいにうまいのです。(しいたけを身体に取り入れるのなんて、たぶんもう確実に20年以上ぶりだ。)

2007/12/13

GhostScriptでヒラギノを使うまとめ

ghostscript でヒラギノが使いたい。

PostScriptで遊んでいて歯がゆいナンバーワンは、後置記法なんかじゃなく、日本語の出力だったりする。gsまわりのパッケージを一通りインストールした Debian であれば、/Ryumin-Light-EUC-H とか指定するだけで、とりあえずは日本語を出力することはできる。でも、そのときに使われるフォントは、/var/lib/defoma/gs.d/dirs/fonts/cidfmap に登録されている TrueType のもの。職場にはきちんとハコで購入したヒラギノがあるのに、何が悲しくて微妙に美しくない TrueType のフォントを使わなければならないのか。最近の ghostscrpt なら OpenType のフォントにも対応しているはずだ。ところが、この cidfmap を編集しても、OpenType のフォントを使えるようにはならないらしい。

そこで、Debian の ghostscript でヒラギノ(というかOpenTypeフォント一般)を使う方法のまとめ。ghostscript のバージョンについては複雑すぎるので省略。少なくとも 8.15 では以下の2つを実行すればいい。
  1. FontResourceDir/CIDFont に、フォントのCIDデータを用意する。
  2. FontResourceDir/Fontに、フォントと同じ名前のファイルを作って、フォント辞書を生成するコードを用意する。
FontResourceDirは、Debianなら/usr/share/gs-esp/*.**/lib/gs_res.psで定義されているディレクトリで、やはりDebianなら/usr/share/gs-esp/*.**/Resource/ になる。(*.**はghostscriptのバージョン。8.15とか)

1. については、フォントのファイル(*.otf)へのシンボリックリンクをFontResourceDir/CIDFont に張っておけばOK。

2. で用意するコードは、たとえばUTF-8の横書き用ヒラギノ角ゴシックW3のものであれば、
/HiraKakuPro-W3-UniJIS-UTF8-H
/UniJIS-UTF8-H /CMap findresource
[/HiraKakuPro-W3 /CIDFont findresource]
composefont
pop
これをHiraKakuPro-W3-UniJIS-UTF8-Hという名前のファイルに保存して FontResourceDir/Font に置く。このファイルは、使いたいフォントとエンコードごとに必要。

ちなみに composefont は、スタックからフォント名とCMapのデータとCIDフォントのデータをとって、フォント辞書を生成し、それをスタックの一番上に積むオペレータ。だから最後に pop がいる。

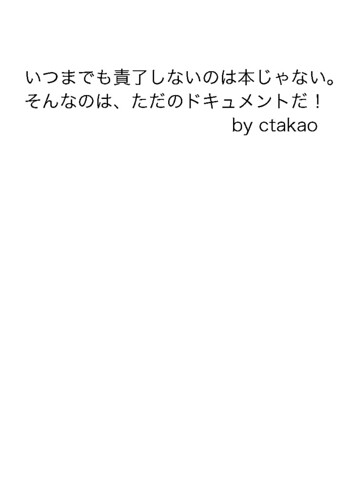
これできれいな日本語が出力できるようになった。
/HiraKakuPro-W3-UniJIS-UTF8-H findfont 30
scalefont setfont
newpath 30 700 moveto ( いつまでも責了しないのは本じゃない。 ) show
newpath 30 660 moveto ( そんなのは、ただのドキュメントだ! ) show
newpath 380 620 moveto ( by ctakao ) show


japanese-test

2007/11/20

追記(2007/12/10)
報告が遅くなりましたが、Jin-Hwan Choさんにすぐに修正対応していただきました。

[cvs] Diff of /dvipdfmx/src/pdfdev.c http://cvs.ktug.or.kr/viewcvs/dvipdfmx/src/pdfdev.c?r1=1.63&r2=1.64

困っている人は、CVSの先端をビルドするか、20071115 のスナップショットに上記のパッチを当てるだけでも大丈夫そう。

追記ここまで


dvipdfmx をアップデートしたら2日間はまってしまった。どうやらetchの dvipdfmx には注意が必要らしい。

自分が遭遇した不具合は2つ。
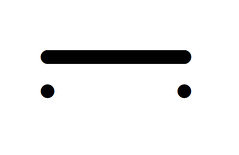
  1. dvipdfmx(20050831)の picture 環境で、multiput の出力がずれる
  2. 細身のCourierフォント(pcrr8rn)が dvipdfmx で細くならない
    http://oku.edu.mie-u.ac.jp/~okumura/texfaq/qa/44806.html
このうち 2. のほうは updmap の問題らしく、TeX Q&A にある土村さんのパッチで解決する。

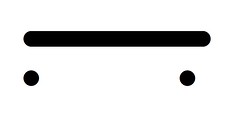
1. については、次のような2種類の図形を描いてみると問題がはっきりわかる。
\begin{picture}(100,10)%
\multiput(0,0)(.1,0){1000}{\circle*{10}}
\end{picture}%

\begin{picture}(100,10)%
\put(0,-10){\circle*{10}}
\put(100,-10){\circle*{10}}
\end{picture}%


上下の picture は、それぞれ同じ幅になることが期待されるけど、dvipdfmx(20050831)では multiput したほうが長くなってしまう。(20070518 でも同じ。)

dvipdfmx-result

dvips で ps にして Acrobat 7.0 で pdf にすると、期待どおり同じ長さになる。(以前のバージョンのdvipdfmx(20040411)でも同じ長さになる。)

dvipd-acrobat-result

原因も修正方法も解明できなかったので、とりあえず報告のメールを送った。

2007/10/20

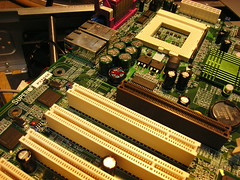
やっぱりSocket370のマザーなんて壊滅だった。唯一すぐ手に入ったまっとうな商品が、SuperMicroのP3TSSEで、実売は23000円。どう考えても2007年の買い物じゃないけど、しかたない。メーカー取り寄せとのことだったけど、「Your Best P4 Motherboard」と書かれた箱に入ってやってきたので、もうメーカーにもまともな在庫はないのかもしれない。

supermicro p3tsse

でもこれ815EだしDDRは使えないんだよな。PC133のメモリも何枚か持っていたはずなんだけど、こないだ古いPCを処分したときに一緒に引き取ってもらっちゃたみたい。さすがにもう使うことはないだろうと思ったと思われる。しかたないのでメモリも買う。512MBで20000円。げー。いまどきPC133のSDRAMって信じられないくらい高額なのね……。6000円くらいのへなちょこなバルク品も試してみたんだけど、認識されなかった。最近はメモリの相性なんてほとんど気にしなくなってたので、ここでふたたび時代に取り残されている感。

2007/10/16

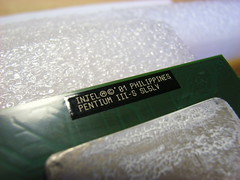
どうやらマザーボードを買い換えないとだめらしい。買い換えるのはいいんだけど、いまどきDDR PC2100に対応したまともなSocket370のボードなんて手に入るのかなあ。


やっぱりTualatinだよね。


tualatin

2007/10/12

SXMLから、ある属性を持つ要素をSXPathを使って取り出したい。たとえば英語と日本語の文章からなるこんなデータから、lang属性が"ja"の要素を取り出したい。
(define e
'(*TOP*
(p (|@| (lang "ja"))
"こんにちはこんにちは"
(emph "日本語です"))
(p (|@| (lang "en"))
"hellohello"
(emph "I got english"))
(m (p (|@| (lang "ja"))
"あしたは休み")
(p (|@| (lang "en"))
"I can't work any more"))))
どうやらSXPathで遊ぶときは、「真偽を返す関数」をsxml:xxxみたいな名前の関数に渡してコンバータを作り、それを要素に適用するというのが常套っぽい。いまは属性をもとに評価したいので、「真偽を返す関数」としては「lang属性の値が"ja"かどうかテストするプロシージャ」になるんだろうな。そして木全体をめぐりたいので、sxml:descendantで作ったコンバータをルートノードに適用すればよさそうだ。
(use sxml.sxpath)
(use sxml.tools)

(define (f r n v)
((sxml:descendant
(lambda (e) (equal? "ja" (sxml:attr e 'lang))))
r))

(define q (sxpath `(,f)))
実行結果
gosh> (q e)
((p (|@| (lang "ja")) "こんにちはこんにちは" (emph "日本語です"))
(p (|@| (lang "ja")) "あしたは休み"))

2007/10/09

つっかかるようなシューベルトが好きといえばわかる人にはわかるとおり、ぼくはアファナシエフの弾くシューベルトが好きだ。で、10月1日に彼が来日してシューベルト弾くというので、トッパンホールにいってきた。さすがに大御所の演奏会だけあっていい値段だったし、聴衆もおじいさんおばあさんが多くてなんだかなーという感じ。彼らの大半はシューベルトだけが目当てなんだろうな。でも残念でした。この日、アファナシエフが弾きたかったのは、途中の休憩をはさんで演目の真ん中に演奏したシルベストロフだったらしい。それをはさんで演奏したシューベルトの即興曲は、明らかに軽く流してた。すごくうまいけど。

そもそもシューベルトの特にピアノ曲は、例えばかわいい女の子といっしょにいる最中に「この楽しい時間はどうしていつか終わってしまうんだろう」みたいに思い始めてしまったときのあの何ともいえない気分が永遠に引きのばされる感じがたまらないと思うんだけど、そういう雰囲気には欠ける演奏だった。楽しい(pleasure)が幸せ(happy)に結び付くとは限らないってダライ・ラマは言ってるけど、だからこそ「楽しさをなんとか引きのばして幸せを錯覚したい」っていう気分にきゅんとなるわけで、そうでないシューベルトは老後の楽しみにはいかもしれないけど(なにしろアファナシエフはすごくうまい)、ぼくが聴きたいのとは違う。

アファナシエフはピアノソナタ18番をレコーディングしてるけど、そこではこの錯覚した幸せ感を満喫できる。こないだの高橋アキの13番にも同じ印象を受けた。10月1日のアファナシエフは、むしろシルベストロフの曲で、この感じを演奏者として楽しんでいた気がする。そういえば高橋アキはアンコールにサティの「おまえがほしい」を弾いて、それを聴いていたときは「ぶちこわしじゃん」と思ったけど、あの堂々巡り感も同じような世界観なのかもしれない。

2007/10/06

自分用のメモ。なんかこんな感じのリストがあるとする。
(define life
'(i (value "2007")
"年"
(ii (value "10")
"月"
(iii (en "9")
"日"))
(delimiter "/")
(value "2009")
"年"
(ii (value "1")
"月"
(iii (en "31")
"日"))
(iii (value "10")
"日")))
一番上の階層のテキスト情報だけを抜きたい。
つまり、iiとiiiのタグの子孫を飛ばして読んでいきたい。結果として得たい文字列は、"2007年/2009年"。

SXPathを使う。
(use sxml.sxpath)

(define (text-self elem)
(sxml:string ((node-self (ntype?? '*any*)) elem)))

(text-self
(cons 'dummy
((sxml:child (sxml:invert (ntype-names?? '(ii iii)))) life)))

2007/09/30

9月20日に高橋アキのピアノドラマティック・シリーズ #5にいってきた。高橋アキについては、一時期よくサティを弾いていた人という認識しかなかったし、今回の演目にもシューベルトの13番とかあったので、もっと「耳にやさしい」コンサートかと思ってたよ。自分のなかでシューベルトブームだったのと、チェロのローハン・デ・サラムが競演してコダーイの無伴奏チェロとかドビュッシーのソナタとかやるということだったので、それなら奥さまがチェロを聴いてみたがっていたしちょうどいいかと思ってチケットを買った。

で、このローハンおじさん、高橋アキがモンポウとかシューベルト13番のような聴き心地のいいクラシカルな演目をやるといってるところに「オレにコダーイをひかせろ」といって殴り込んできただけのことはある。メロディックなさじ加減ゼロ。たとえばヨーヨー・マのひくコダーイは、このむちゃくちゃハードな技巧の曲を可能なかぎり美しく聴かせようみたいなサービス精神に溢れているんだけど、ローハンおじさんにそんな気配はない。最後の一音なんて、ほとんど放り投げてるもんな(ヨーヨーのCDでは、たっぷり響かせて終わる)。もう、この演奏だけでファンになりました。翌週の27日にも渋谷でローハンおじさんが聴けるというので、もちろんそちらにもいってきた。

27日のほうは、フルートのカリン・レヴァインと競演で、現代曲オンリー。50人くらいしか聴衆のいない小さな演奏会だったけど、これがまた強烈だった。ローハンおじさんはコダーイに加えて、クセナキス(本人はゼナキスと発音してた)と松村禎三(!)のソロ曲を演奏してくれた。クセナキスはもともとプログラムにあって、期待もしてたんだけど、ゆうに期待を裏切ってくれる。松村禎三は、追悼として当日プログラムに追加されていた。17絃箏のための祈祷歌をチェロ独奏むけにアレンジしたものらしい。最初からチェロ独奏の曲でしょうっていうくらいの完成度なんですが、それは松村禎三の曲の力ですか、それともローハン・デ・サラムのうまさですか。なんかいま東京でレコーディングしているらしいんだけど、コダーイはもちろん、このクセナキスのKottosと松村禎三をなんとか収録していただけないものでしょうか。

この日はフルートのカリン・レヴァインさんもよかったな。とくにカイヤ・サーリアホとジャチント・シェルシ。フルートってこんなにいろんな音が出る楽器だったんですね。バスフルートやアルトフルートの独奏曲を生で聴く機会があるとは思いませんでした。

高橋アキを忘れていたわけではなく、9月20日の演奏にはものすごく共感するんだけど、いかんせん後にやった9月27日の演奏会の印象のほうが強烈に残っているのですっかり話がずれた。とくに、つっかかるようなシューベルトは、そうでなければシューベルトをあえて聴く意味はないよねと個人的にはすごく同意したい。

2007/09/23

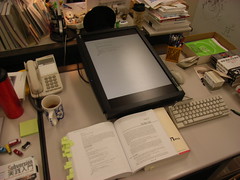
現在の書籍の製作スタイルでは、横長のモニターを縦にして使うほうが都合がいい。とにかくビルドしたPDFのページを画面いっぱいに大きくして確認したいのである。そして書籍のページというものは横長ではなく縦に長い。ところが職場で使っている24インチのモニターはスタンドがへぼくて縦にして使うことができない。それでスタンドをはずして机の上に平置きにして無理やり縦にして使ってみた。

R0011978

これがあんがい使える。廃熱も大丈夫なようだ。

本当はPDFを見開きで確認したいので、このサイズのモニターが二枚はほしいところ。もちろんちゃんとアームつきでな。

2007/08/20

先週、2004年ごろには Gauche に KAKAI のライブラリがあったらしいとか書いたけど、sourceforge のページから今でもダウンロードできると shiro さんに教えていただいた。ありがとうございます。(そして、ろくに確認せず適当なことを書いていてすみません。)

しかもインストールしたら使えた。
(use text.kakasi)
(kakasi-begin :JH :p)
(display (kakasi-convert "素子"))
(newline)
(kakasi-end)
これを kakasi-trial.scm とすると、
$ gosh -V
Gauche scheme interpreter, version 0.8.10 [utf-8,pthreads]
$ gosh kakasi-trial.scm
{もとこ|そし}

2007/08/17

[2010年6月3日 追記]改良版はこちら

emacs で、検索パターンをその後の編集中ずっとハイライトにしたい。インクリメンタルサーチの結果でもハイライトされるけど、あれだと編集をはじめるとハイライトが解除されてしまうので、使えない。
具体的には、作業中のバッファであるパターンを一時的にハイライトして、それを確認しながらを作業するための方法がほしい。こんな具合。

highlight

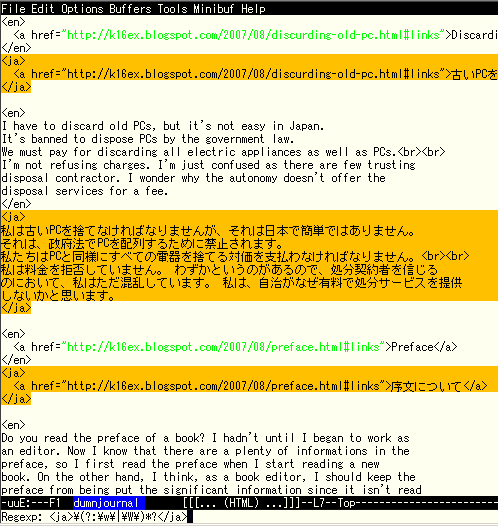
この例は、 ja タグで囲まれた部分をハイライトするようにしたところ。普段はハイライト不要なんだけど、たとえば「 ja にも en にも出てくる語を検索して周辺の文章を編集したいんだけど en 内にあるほうは無視してもいいや」といった作業に便利じゃない?

で、とりあえず作ってみた関数。
;;; let designated pattern be highlight
(defun highlight-regexp (re)
(interactive "sRegexp: \n")
(make-face 'my-highlight-face)
(set-face-foreground 'my-highlight-face "black")
(set-face-background 'my-highlight-face "yellow")
(defvar my-highlight-face 'my-highlight-face)
(setq font-lock-keywords (list (list re 0 my-highlight-face t)))
(font-lock-fontify-buffer))
M-x highlight-regexp すると正規表現の入力を促されるので、そこで適切なパターンを指定すると、上の例のようにハイライトされる。そういえば解除するときのことは考えてなかった。あと、上の例ではなんとなく改行をまたいだマッチに成功してるけど、emacs の正規表現である以上、改行をまたいだパターンのマッチは期待通りにいかないと覚悟すべき。やっぱりこのエディタは、本当のところは文章のパワー編集には向かないんじゃないだろうか。

まあ問題はあるけど、ここまではよかった。

実はいま c さんに、「xyzzy で同じことがしたい」と脅されている。xyzzy は普段使ってないから、色の付け方とかわからんのですよ……。
Windows なら EmEditorとかで GUI のメニューから同じようなことができるから、とりあえずそっちでいいんじゃないかなあ。だめ?

2007/08/16

2007/08/15

cさんに「索引の読み仮名をひらがなで明示的に指定するのは前時代すぎてあほみたいだ。休み明けまでに何とかしとけ」と恫喝されたので、彼女が休みのあいだに急いで対策することにした。

まあ、実際の cさんはそんなひどい言い方をする人ではなく、ちょうかわいいんだけど、たしかに LaTeX ベースで本を作っていると索引のふりがな入力がうっとうしい。労力の問題だけでなく、原稿にひらがなが氾濫して読みにくくなるという意味でもうっとうしい。

漢字かな変換にはKAKASIを使うのが常套なんだろうな。Gauche には Ruby とちがって KAKASI のライブラリはないけれど、ほとんどジョーカーみたいな c-wrapper がある。
これで libkakasi.h に宣言されているCの関数が Gauche から使える。
(use gauche.charconv)
(use c-wrapper)
(c-load-library "/usr/lib/libkakasi.so.2.1.0")
(c-include "/usr/include/libkakasi.h")

(define (kanji->hira str)
(let ((base-ces "utf-8")
(kakasi-ces "iso2022jp"))
(kakasi_getopt_argv 3 '("kakasi" "-JH" "-p"))
(ces-convert
(x->string (kakasi_do (ces-convert str base-ces kakasi-ces)))
kakasi-ces base-ces)))
KAKASIがUTF-8を扱えないのが厄介だけど、それ以外はとても素直に Gauche で漢字かな変換ができる。

gosh> (kanji->hira "素子")
{もとこ|そし}
さて、この「素子」のようにユニークな読みを決定できない項目があると困っちゃうんだけど、「もとこ」か「そし」かの判断を機械的にすべきではなさそうだ
(「この素子を開発したのは素子さんです」問題)。だから、こういうのだけは人力であらかじめ指定しておくのが最適な対応だと思うのですが、それでかまわないでしょうか?> cさん
こんなふうにマークアップ原稿がLaTeXへと変換されるようにします。
<p>
この素子を開発したのは素子さんです。
<indexterm><i1 sortas="そし">素子<i2>開発者</i2></i1></indexterm>
<indexterm><i1 sortas="もとこ">素子</i1></indexterm>
<indexterm><i1>開発者</i1></indexterm>
</p>

この素子を開発したのは素子さんです。\index{そし@素子!かいはつしゃ@開発者}\index{もとこ@素子}\index{かいはつしゃ@開発者}


参考:
今日の一行::ひらかなのインデックス の cut-sea さんの解
ごとけんさんの ruby-kakasi の kakasi.c

2007/08/10

もう、PostScriptでフィボナッチ数列くらいなら昼休みにコーヒー飲みながらでも考えられる。
/fib {0 1 2 index -1 1 {pop exch 1 index add} for} def

ただ、せっかく PostScript なので、結果を印刷とかもしたい。印刷には show オペレータを使うわけだけど、show は文字列(string)しかとれない。fib オペレータが返すのは数値(integer)なので、文字列の型に変換する必要がある。

PostScript で型を文字列に変換するには、=string cvs とすればいいようだ。
%!
/fib {0 1 2 index -1 1 {pop exch 1 index add} for} def
/Palatino-Linotype findfont 300 scalefont setfont
10 10 moveto
11 fib == =string cvs show
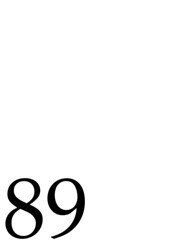
これでページの左下に大きく「89」と印刷される。やっぱりPalatinoフォントの数字は美しい。

fib-11

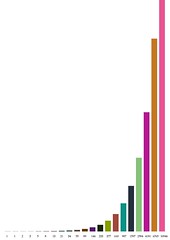
さらにグラフなど描いてみる。
%!
/fib {0 1 2 index -1 1 {pop exch 1 index add} for} def
20 setlinewidth

1 1 21 { % for
/i exch def
/x 27 i mul def

0 setgray
/Palatino-Linotype findfont 10 scalefont setfont
10 x 5 sub exch moveto
i fib == =string cvs show

/r {rand i mod 21 div} def
r r r setrgbcolor
newpath
x 30 moveto
i fib == 10 div 30 add x exch lineto
stroke
} for

showpage

fib

2007/08/07

PostScript で階乗のつづき。こんどは for 文で。
/func {1 exch -1 1 {mul} for} def
ようするに、自分がしたい操作に必要な変数が、適切な数だけ適切な順番でスタックに積まれているようにすればいいらしい。そしてスタックというやつからは、直前に積んだものだけを取り出すことができる。

たとえば上記で定義した階乗のオペランド func を以下のように呼び出すと、
GS> 5 func
まず 5 がスタックに積まれる。この 5 は「funcへの引数」のつもりなんだけど、スタックから見るとそんなつもりはなくて、ただ値が積まれただけ。次は func を積むんだけど、func は上記のように定義されているので、その定義の一番最初にある 1 がスタックに積まれる。この時点のスタックの状態はこんな感じ。
 1 
---
5
func の定義によれば、次は exch だ。これは、それまでスタックの1番上にあった要素とその下の要素を入れ替える。つまり、スタックの状態はこうなる。
 5
---
1
さらに -1 と 1 を順番に積んで、スタックの状態はこうなる。
 1 
---
-1
---
5
---
1
ここで、本文が mul だけの for が登場する。for というオペレータは、スタックの値を 3つ消費し、それぞれの値を深いほうから順番に「繰り返しの最初」「繰り返しの更新」「繰り返しの終わり」として本文を繰り返す。ただし毎回の繰り返しでは、スタックの先頭に、そのターンにおける変数のようなものが積まれる。こう書くと複雑だけど、ようは最初に本文を実行するときには「5」が、2回目は「4」が、...、5回目は「1」がスタックの先頭に積まれるということ。つまり1回目の繰り返しのとき、スタックの状態はこう。
 5
---
1
本文の mul は、このスタックから値を 2つ取り出して、それらの積をあらためてスタックに積む。したがってスタックの状態は、
5
2回目の繰り返しに際してスタックの先頭に「4」が積まれる。
 4 
---
5
このスタックで mul を適用すると、
 20
3回目の繰り返しに際してスタックの先頭に「3」が積まれる。
 3 
---
20
mul を適用して
 60
4回目の繰り返しに際してスタックの先頭に「2」が積まれる。
 2 
---
60
mul を適用して
120
5回目の繰り返しに際してスタックの先頭に「1」が積まれる。
 1 
---
120
mul を適用して
120
おしまい。こうして最後のスタックの値を取り出せば(そのためには == を使う)、5の階乗の値が得られる。

たぶん用語の使い方はいいかげん。はやく教科書こないかな。

2007/08/06

PostScript が意外におもしろいので真剣に勉強してみようと思う。教科書は、Web で PDF が全部公開されている "Thinking in PostScript" に決めた。書籍はもうとっくに絶版らしい。でも物理的な本が手もとにないとつらいんだよなあ。Amazon マーケットプレイスにも出品されているけどバカみたいに高額なので(6000円以上)、US の同様のサービスに注文した(600円くらい)。まだ届かない。出荷された気配もない。もう待ちきれないよう。

というわけで、試行錯誤しながら階乗を考えてみた。
 /func {dup 1 eq {1 mul} {dup 1 sub func mul} ifelse} def
実行結果。
GS> 10 func ==
3628800
GS> 20 func ==
2.43290202e+18
GS> 100 func ==
inf.0
どうやら再帰的なオペレータの定義ができるらしい。はじめは、ふつうに for を使って解こうとしたんだけど、わかりませんでした。

ところで Emacs の ps-mode は GS のビューワーと連動して出力結果がリアルタイムで見られてすごい。便利すぎ。ただしお絵描きを始めると日付が変わるようだ。